Continguts i IA
Automatització editorial per a Pànxing.net
Una aplicació que transforma documents, cartells, programes i altres materials editorials en esborranys preparats per revisar i enviar a WordPress, mantenint el control sobre les fonts i les dades importants.
- Estat
- MVP funcional en desplegament controlat
- Rol
- Desenvolupador principal
Problema
Crear continguts per a un portal editorial implica molt més que redactar un text. Cada material que arriba a l'equip pot tenir un format diferent i contenir només una part de la informació necessària. Un document pot incloure una descripció completa, mentre que un cartell pot mostrar únicament el títol d'una activitat, una data i una hora. A partir d'aquest material cal preparar un contingut amb una categoria, un municipi, una estructura editorial, informació SEO i les imatges corresponents. També cal assegurar-se que les dades publicades coincideixen amb la font original. Aquest últim punt és especialment important en les agendes. Si el sistema inventa un any, afegeix un lloc que no apareix al cartell o completa una activitat que no estava indicada, el resultat pot semblar correcte però contenir informació falsa. El repte era automatitzar part del procés sense perdre la precisió editorial ni obligar l'editor a revisar-ho tot des del principi.
Context
Pànxing.net és un lloc web que recull la informació publicada a les revistes impreses de les capçaleres Pànxing Cerdanya, Pànxing Maresme i Pànxing Berguedà.
Per elaborar aquestes revistes, l’equip rep materials molt diferents: documents Word, PDFs, textos, cartells, programes d’activitats i fotografies.
Aquests materials han d’acabar convertits en continguts per al web i, posteriorment, en entrades de WordPress segons la categoria i el municipi corresponents.
El projecte es va crear per ajudar en aquest procés: llegir els materials, preparar una primera proposta editorial i deixar que l’editor es concentrés en confirmar dades, resoldre dubtes i aprovar el resultat.
Evolució del projecte
El projecte va començar amb una idea general: crear una eina que ajudés a transformar materials editorials en continguts per a Pànxing.net.
La primera versió va servir per validar el concepte. Es va provar si era possible extreure informació, classificar els materials i generar textos amb IA.
A mesura que es van provar casos reals, van aparèixer nous problemes: documents incomplets, cartells difícils de llegir, classificacions incorrectes, dates amb formats diferents i continguts que necessitaven tractaments editorials diferents.
Les versions següents van anar incorporant el flux complet: importació de materials, classificació, generació de continguts i exportació a WordPress.
Una de les versions intermèdies, que internament es va considerar una V2 però que en realitat correspondria a una tercera etapa, va afegir gran part de la base actual del projecte.
A partir d’aquesta base es van incorporar:
- revisió de fonts;
- fets detectats i evidències;
- perfils editorials;
- regles SEO;
- estructures per categoria;
- preparació d’imatges;
- correcció manual;
- validació abans de l’exportació;
- sincronització SMB;
- processament persistent de lots;
- reintents selectius;
- enviament idempotent a WordPress.
La versió actual és el resultat d’aquest procés. Ja no és només un prototip per comprovar si la idea funcionava, sinó un MVP funcional que resol el flux principal i permet continuar escalant-lo.
Funcionament
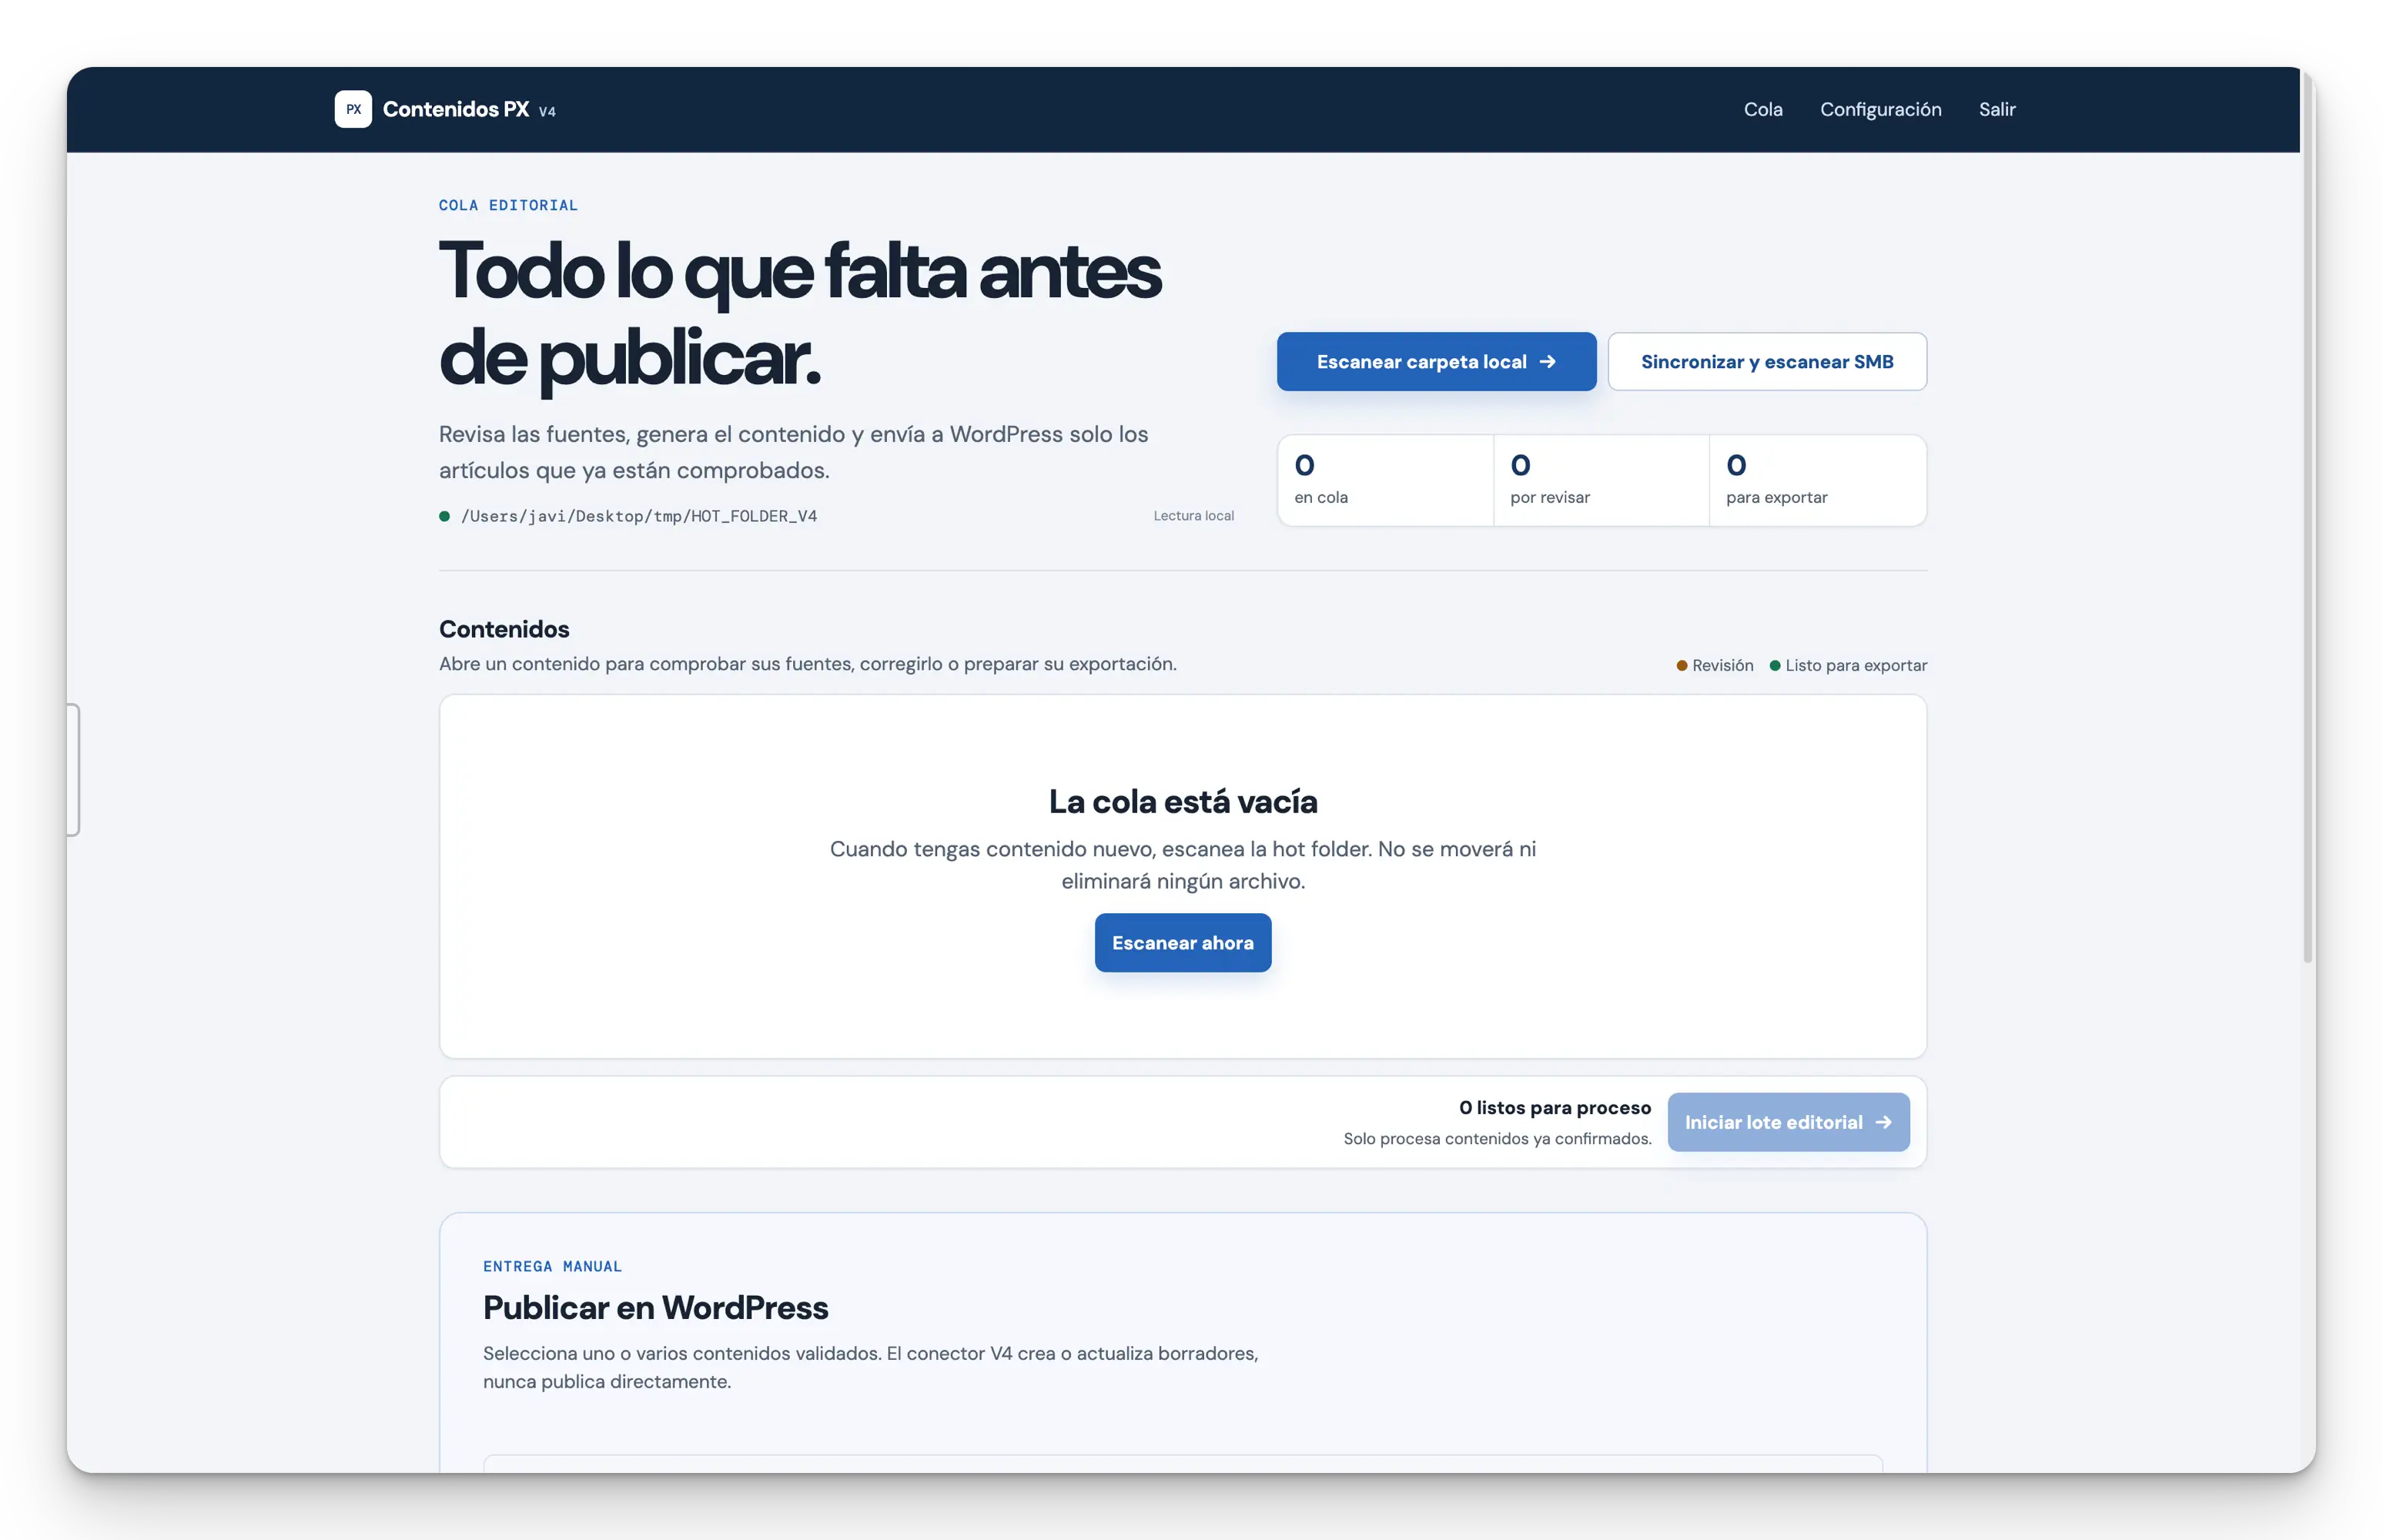
1. Sincronització amb SMB
L’editor inicia manualment la sincronització amb la carpeta compartida SMB.
L’aplicació recorre els fitxers compatibles, els copia al seu propi espai de treball i calcula una empremta SHA-256 per evitar duplicats.
Els fitxers originals no es mouen, no es canvien de nom i no s’eliminen.
La sincronització funciona com un treball independent. La interfície mostra el progrés de la còpia i permet veure quins elements s’han importat, quins ja existien i quins han fallat.
2. Anàlisi de les fonts
Quan la còpia ha acabat, comença una segona fase d’anàlisi.
El sistema extreu text de fitxers DOCX, PDF, TXT i Markdown. En el cas de les imatges, pot utilitzar OCR local, transcripció visual amb IA o totes dues opcions.
Els resultats es conserven per separat. Això permet comprovar què ha llegit l’OCR, què ha interpretat el model visual i quina informació prové directament del document.
Si un contingut falla, el problema queda associat només a aquell element. La resta del lot pot continuar i l’element fallit es pot reintentar més endavant.
3. Classificació
La classificació inicial utilitza la carpeta i el nom dels fitxers. Després, l’aplicació pot analitzar el contingut per confirmar o proposar una altra categoria i municipi.
Les opcions disponibles provenen d’un catàleg configurat. Si la classificació inicial i l’analitzada no coincideixen, el sistema mostra la diferència i demana que l’editor la confirmi.
La categoria determina el tractament editorial i també el tipus de contingut que s’enviarà a WordPress.
4. Revisió de fonts
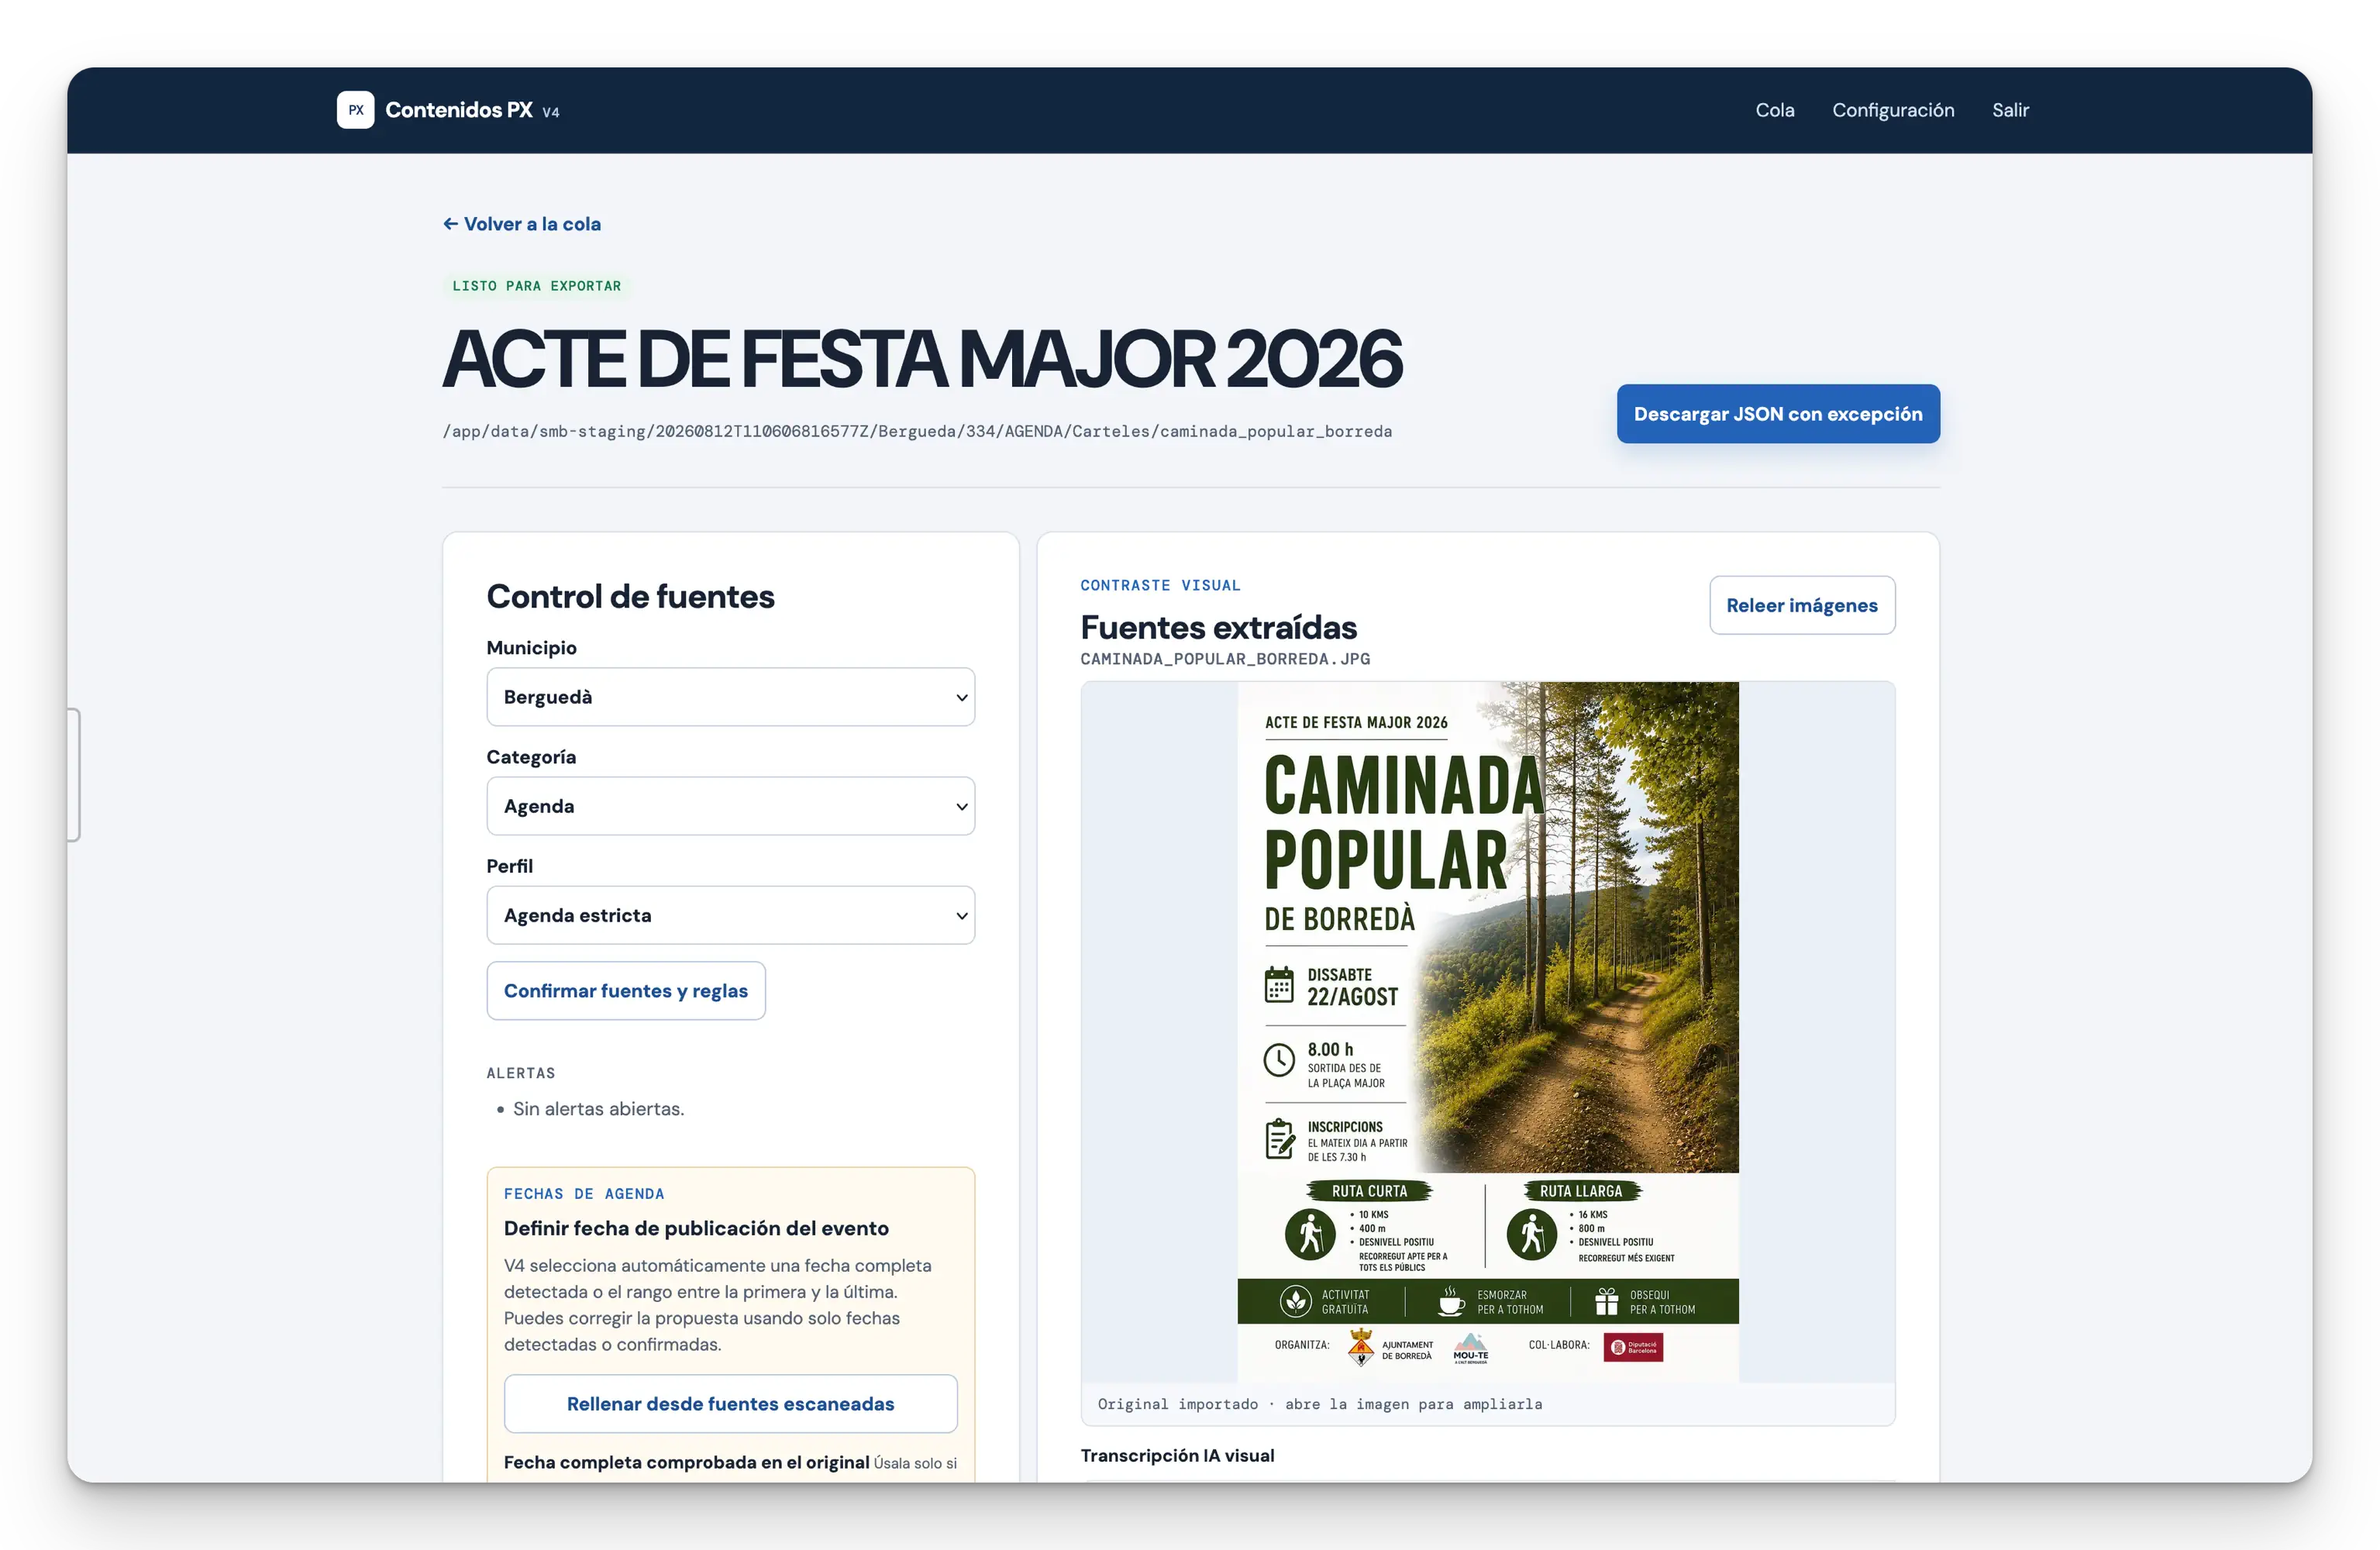
Abans de generar l’article, l’editor pot obrir la fitxa del contingut.
En aquesta fitxa pot consultar els fitxers originals, el text extret, la transcripció visual, les imatges i els fets detectats.
També pot afegir dades confirmades o instruccions editorials. Per exemple, pot confirmar una data completa que no es llegeix bé al cartell o indicar que una entrevista s’ha de conservar amb el seu format de preguntes i respostes.
Aquest pas permet resoldre els dubtes abans de redactar i evita que la IA intenti completar automàticament les parts que falten.
5. Generació del contingut
Quan les fonts ja s’han revisat, es genera l’esborrany editorial.
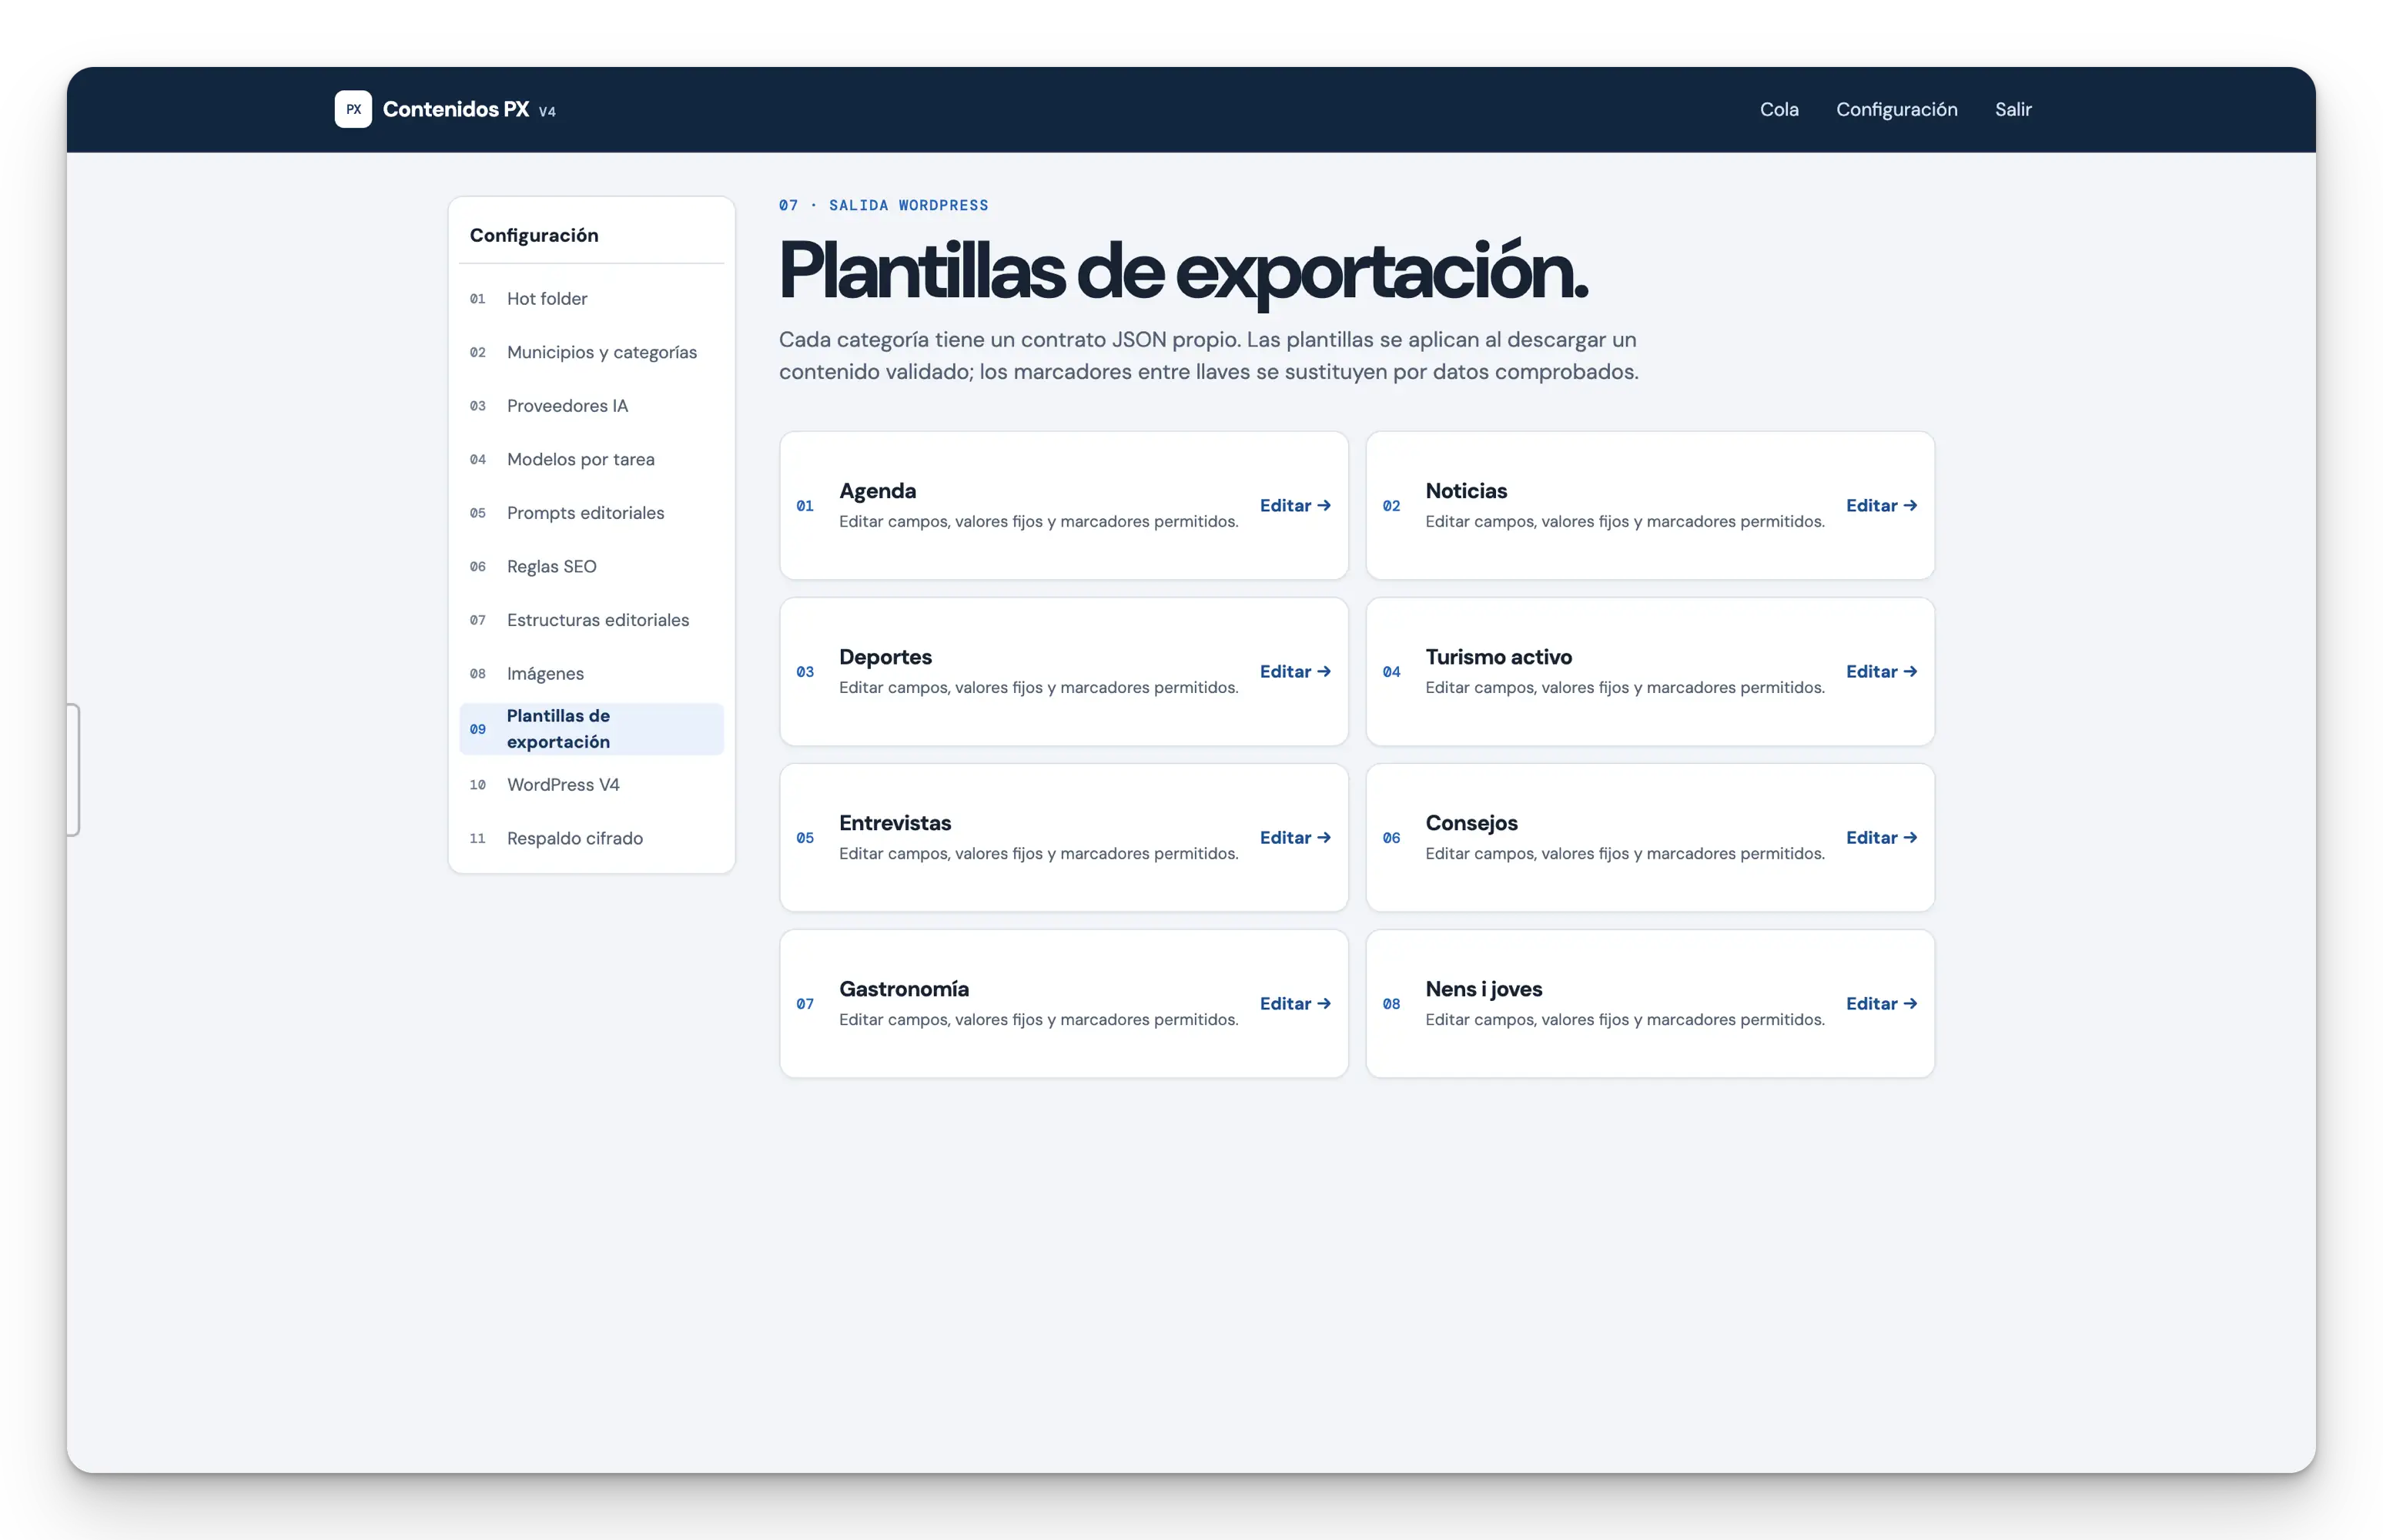
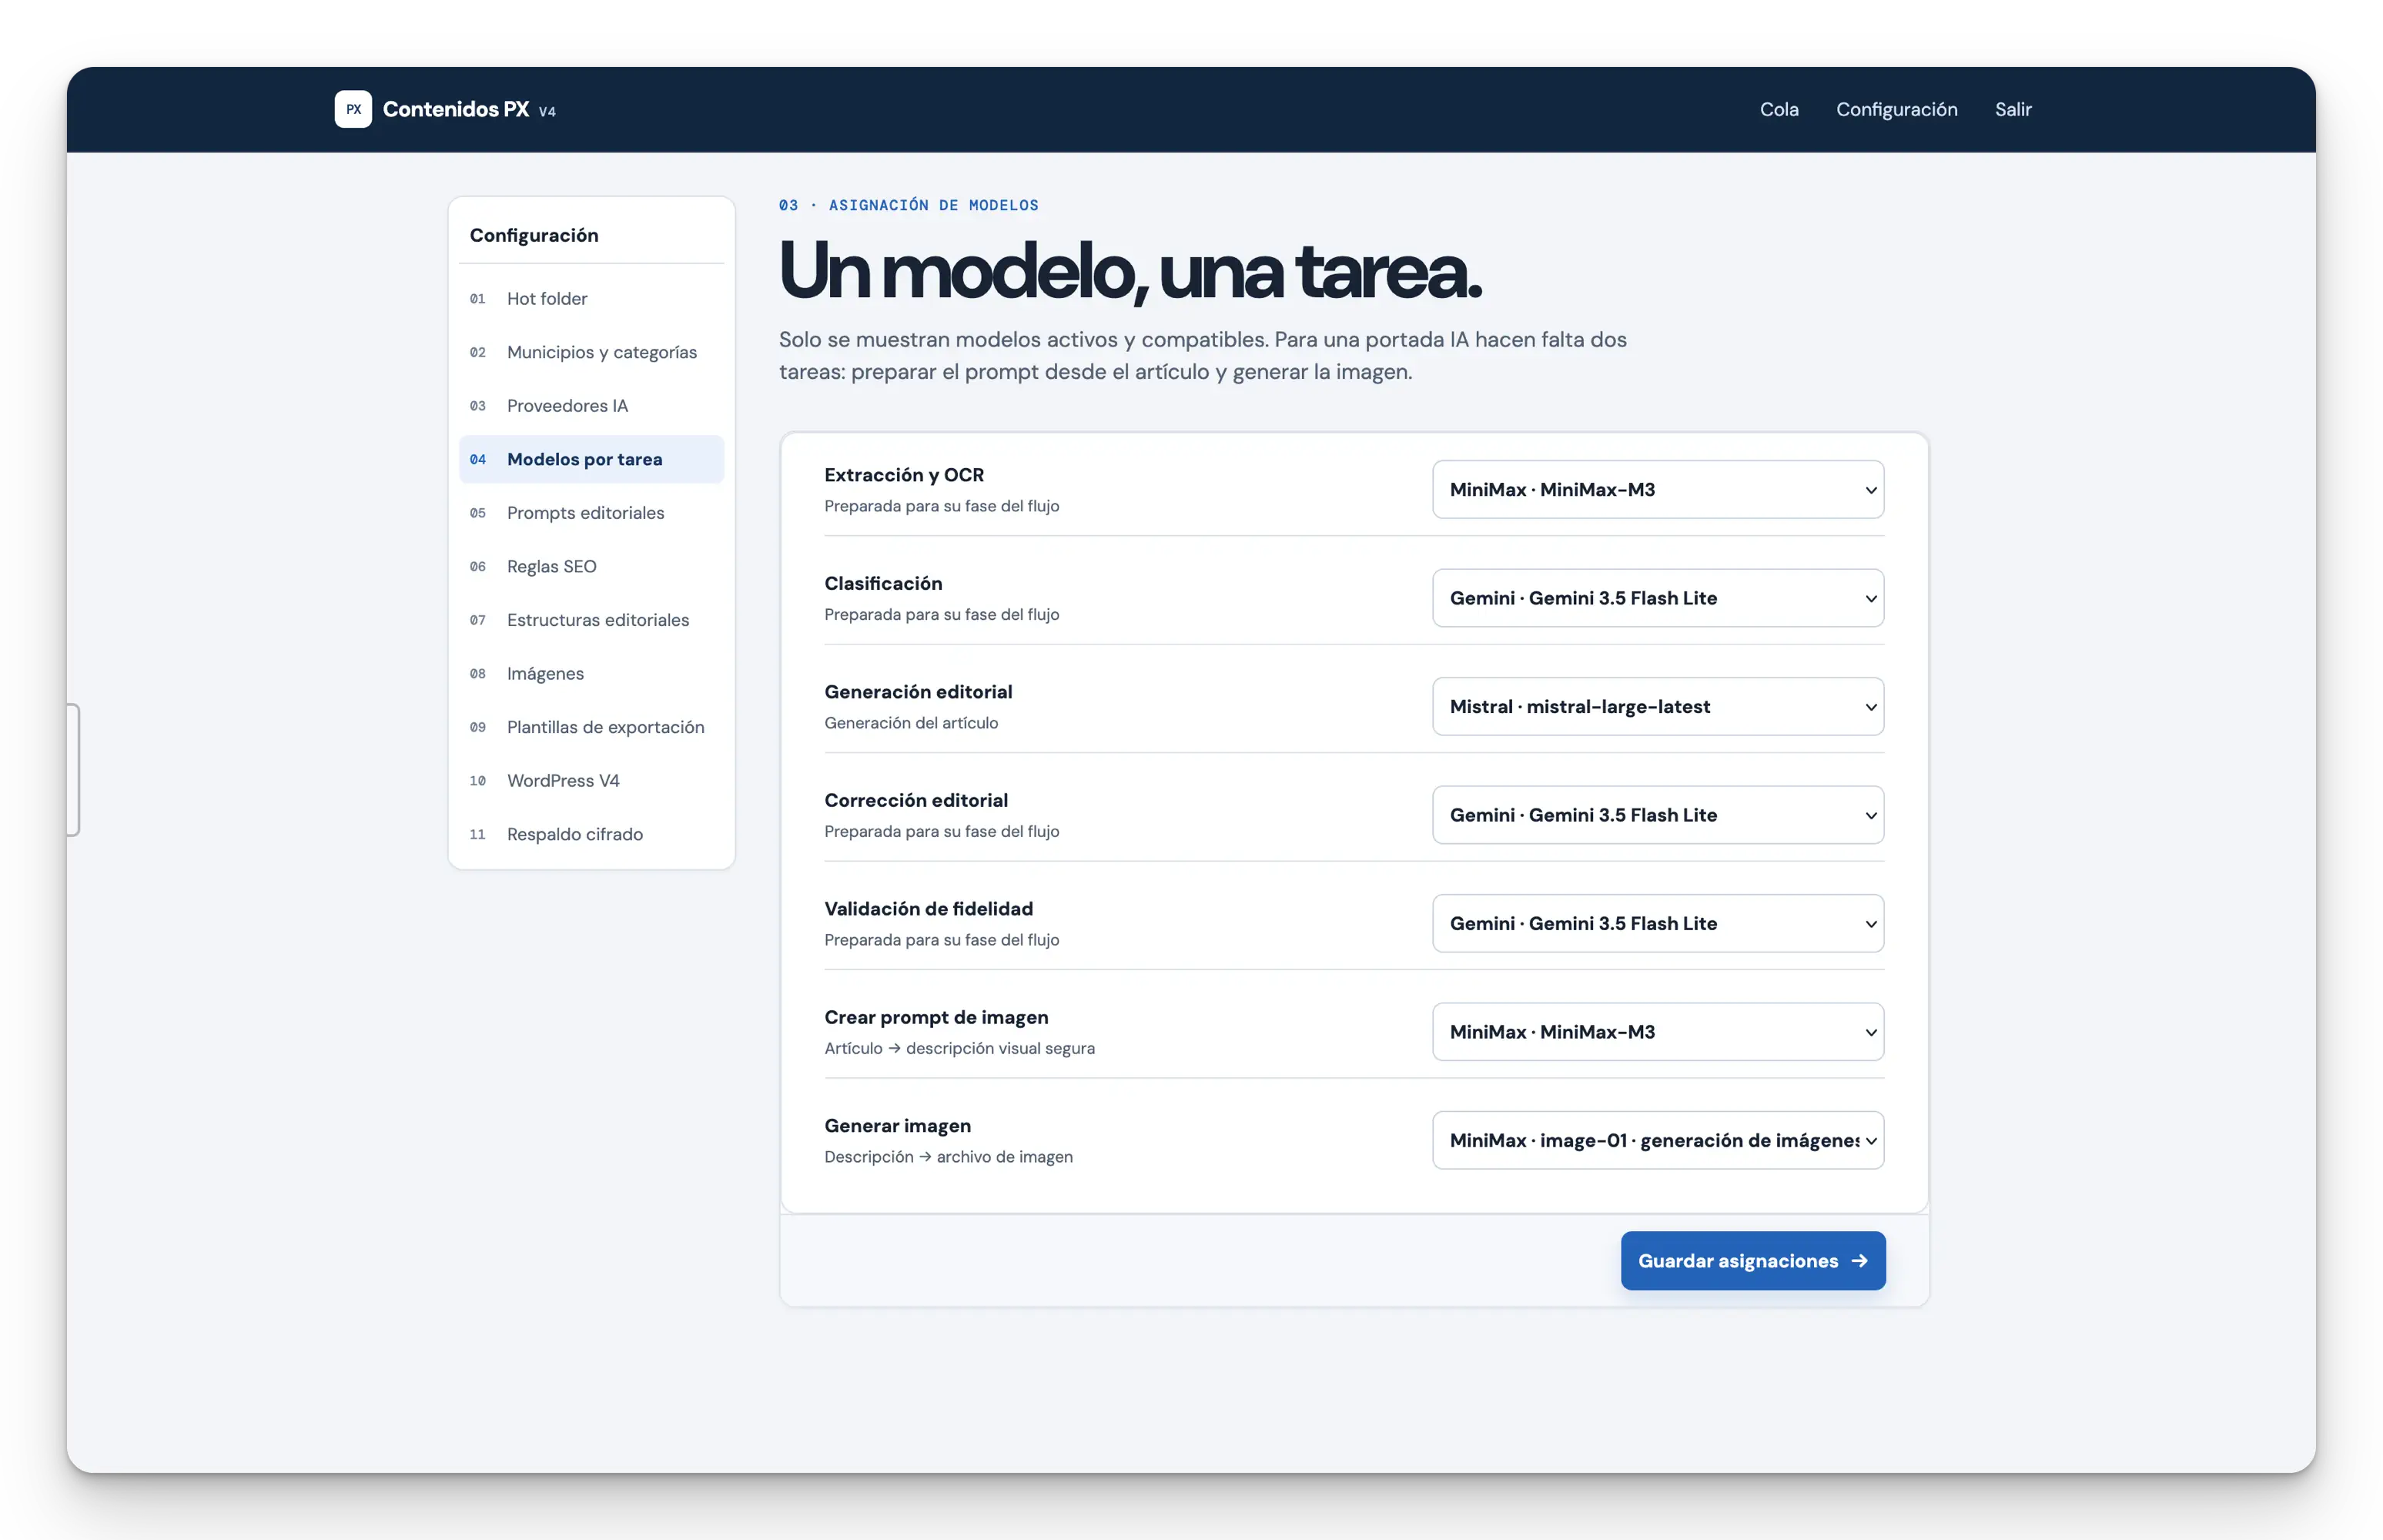
La configuració permet assignar diferents proveïdors i models segons la tasca: classificació, transcripció visual, generació, correcció, validació o generació d’imatges.
Els perfils editorials principals són:
- Agenda estricta: conserva el programa i només utilitza dades confirmades.
- Entrevista literal: manté les preguntes, les respostes i l’ordre original.
- Client fidel: corregeix el text amb una intervenció mínima.
- Editorial controlat: millora l’estructura sense afegir informació nova.
La IA ajuda a ordenar i redactar el contingut, però no pot completar les dades que falten.
6. Tractament de les agendes
Les agendes han estat una de les parts més difícils del projecte.
Un programa pot tenir diverses activitats, dies diferents, hores, preus i ubicacions. A més, la informació pot aparèixer en formats diferents o estar repartida entre diverses pàgines i imatges.
Les dates no les decideix la IA. L’aplicació les normalitza amb codi i diferencia entre esdeveniments d’un sol dia, llistes de dies i períodes amb data d’inici i de final.
Si una data no és completa o no es pot verificar, l’agenda queda bloquejada fins que l’editor la confirma.
Això evita que el sistema dedueixi l’any, inventi una data final o transformi una informació parcial en un esdeveniment incorrecte.
7. Imatges
Les imatges importades es conserven juntament amb el contingut al qual pertanyen.
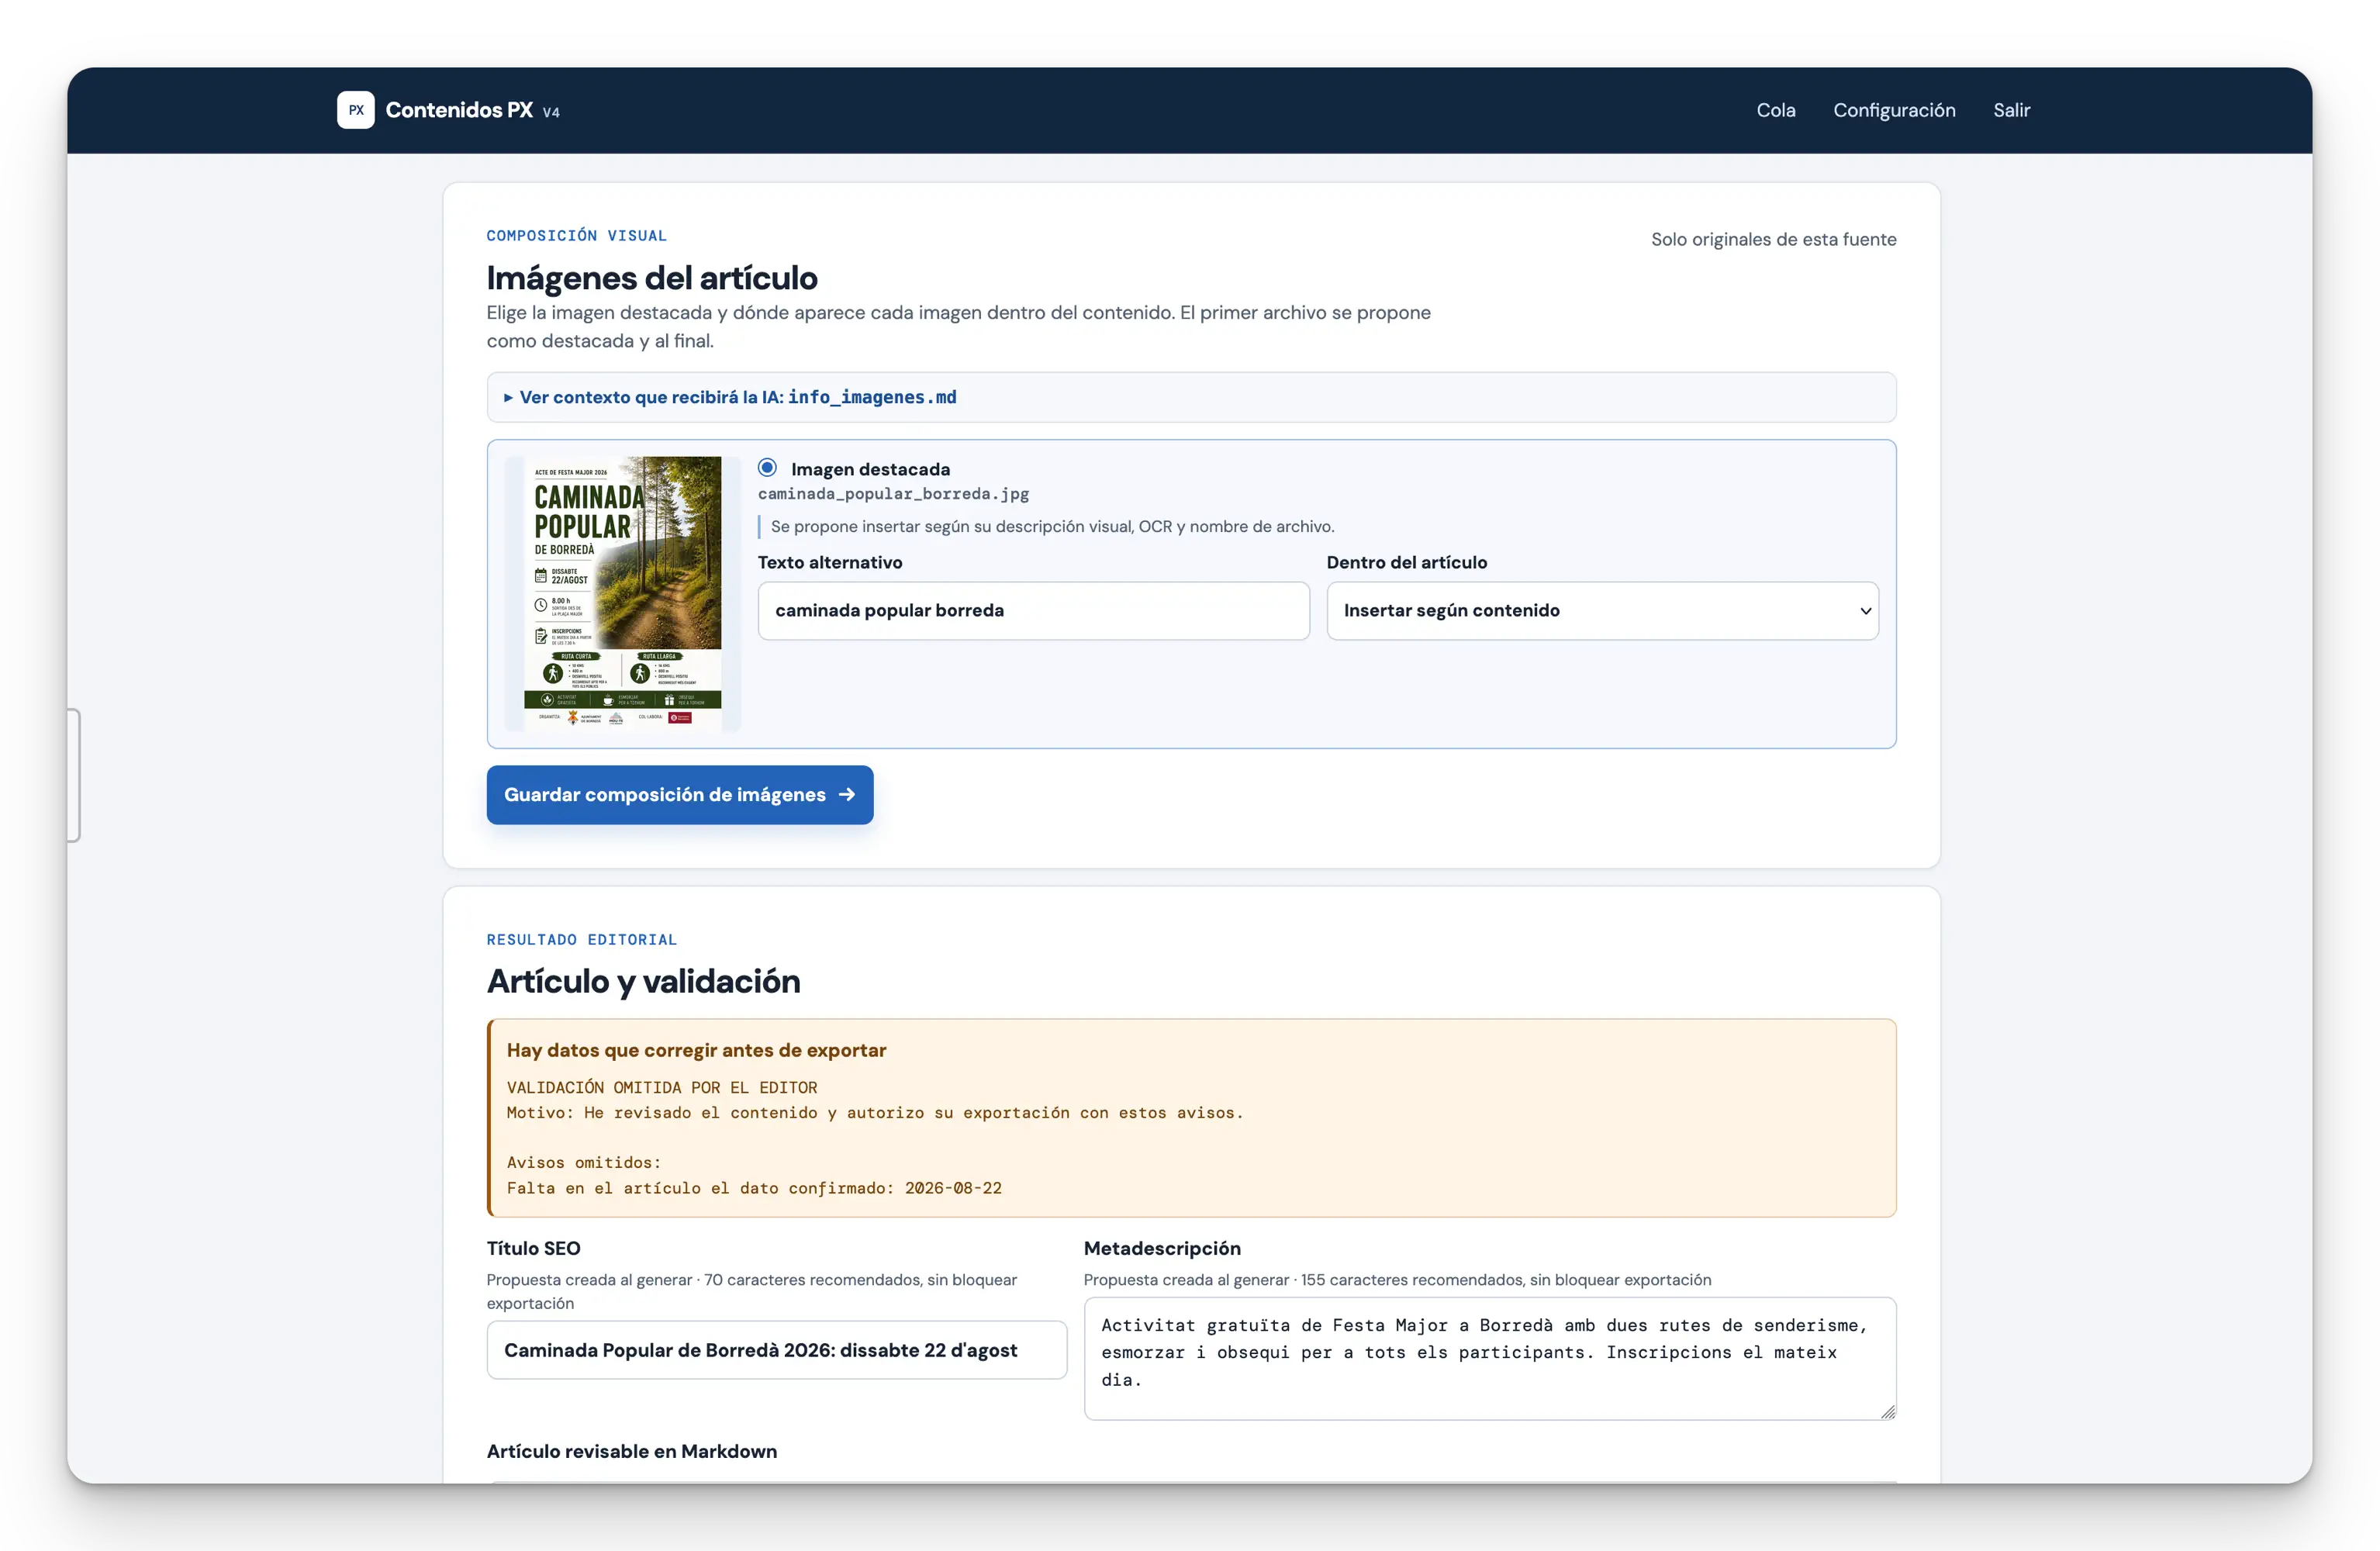
L’aplicació pot crear versions optimitzades per al web sense modificar l’original. L’editor pot seleccionar la imatge destacada, afegir el text alternatiu i decidir quines imatges apareixen dins de l’article.
Quan no hi ha cap imatge disponible, es pot generar una portada amb MiniMax. Aquesta imatge queda identificada com a generada per IA i no es considera una font informativa.
8. Validació
Abans d’exportar, el contingut passa per una validació automàtica.
La validació comprova dates, hores, preus, municipis, categories, metadades i fets principals. També detecta informació crítica absent, contradiccions i dades que no estan justificades per les fonts.
Els resultats es divideixen en:
- Correcte: el contingut es pot exportar.
- Avís: hi ha una millora possible, però no bloqueja el procés.
- Error: cal corregir o confirmar la informació abans de continuar.
L’editor pot modificar el Markdown des de la mateixa fitxa i tornar-lo a validar.
9. Enviament a WordPress
Quan el contingut és vàlid, es crea un treball d’enviament a WordPress.
El sistema prepara el payload segons la categoria, assigna el CPT corresponent, vincula el municipi i afegeix les taxonomies i metadades necessàries.
També envia només les imatges seleccionades i utilitza un identificador estable per evitar duplicats en cas de reintent.
WordPress rep sempre un esborrany. La publicació definitiva continua depenent de la revisió editorial.
Dificultats
Començar amb una idea i convertir-la en un producte funcional
El projecte no va començar amb una especificació tancada. Al principi només estava clara la finalitat general: ajudar a preparar els continguts de Pànxing.net.
El procés va consistir a crear prototips, provar-los amb materials reals, comprovar què funcionava i detectar quines parts no aportaven prou valor.
Algunes idees semblaven bones inicialment però complicaven el flux o no eren prou fiables. Això va obligar a simplificar, separar fases, prioritzar les funcions importants i convertir el prototip inicial en un MVP funcional.
Generar continguts sense crear informació falsa
La generació amb IA era útil, però també era la part amb més risc.
El sistema havia de poder transformar un text breu o un cartell en un article llegible sense afegir dades que no apareguessin a la font.
Per aconseguir-ho, es van combinar prompts, perfils editorials, fets detectats, instruccions de l’editor i validacions independents.
La generació havia de servir per redactar millor, no per omplir els buits amb informació inventada.
Crear agendes fiables
Les agendes van concentrar una gran part de la complexitat del projecte.
No n’hi havia prou amb extreure el text d’un cartell. Calia conservar totes les activitats, interpretar correctament les dates, diferenciar rangs, detectar informació incompleta i preparar les dades que necessita WordPress.
La solució final separa la redacció de la gestió de dates. La IA pot ajudar a redactar el contingut, però les dates es calculen i es validen de manera determinista.
Llegir cartells i documents visuals
Els cartells poden tenir columnes, tipografies decoratives, fons complexos o informació molt condensada.
L’OCR local és útil, però no sempre interpreta bé la distribució visual. La transcripció amb IA pot aportar una lectura millor, però també s’ha de revisar.
Per això l’aplicació conserva els resultats de les dues vies i els mostra a l’editor abans de generar l’article.
Processar lots amb errors parcials
Una sincronització pot contenir molts fitxers i no tots fallen pel mateix motiu.
La solució va ser crear treballs persistents amb progrés per element, reintents selectius i recuperació després d’un reinici.
Així, un error de connexió, d’OCR o de WordPress no obliga a començar tot el procés de nou. Només cal reintentar els elements que no han completat la seva fase.
Resultat
El projecte ha convertit un procés editorial manual en un flux de treball més ordenat i controlat.
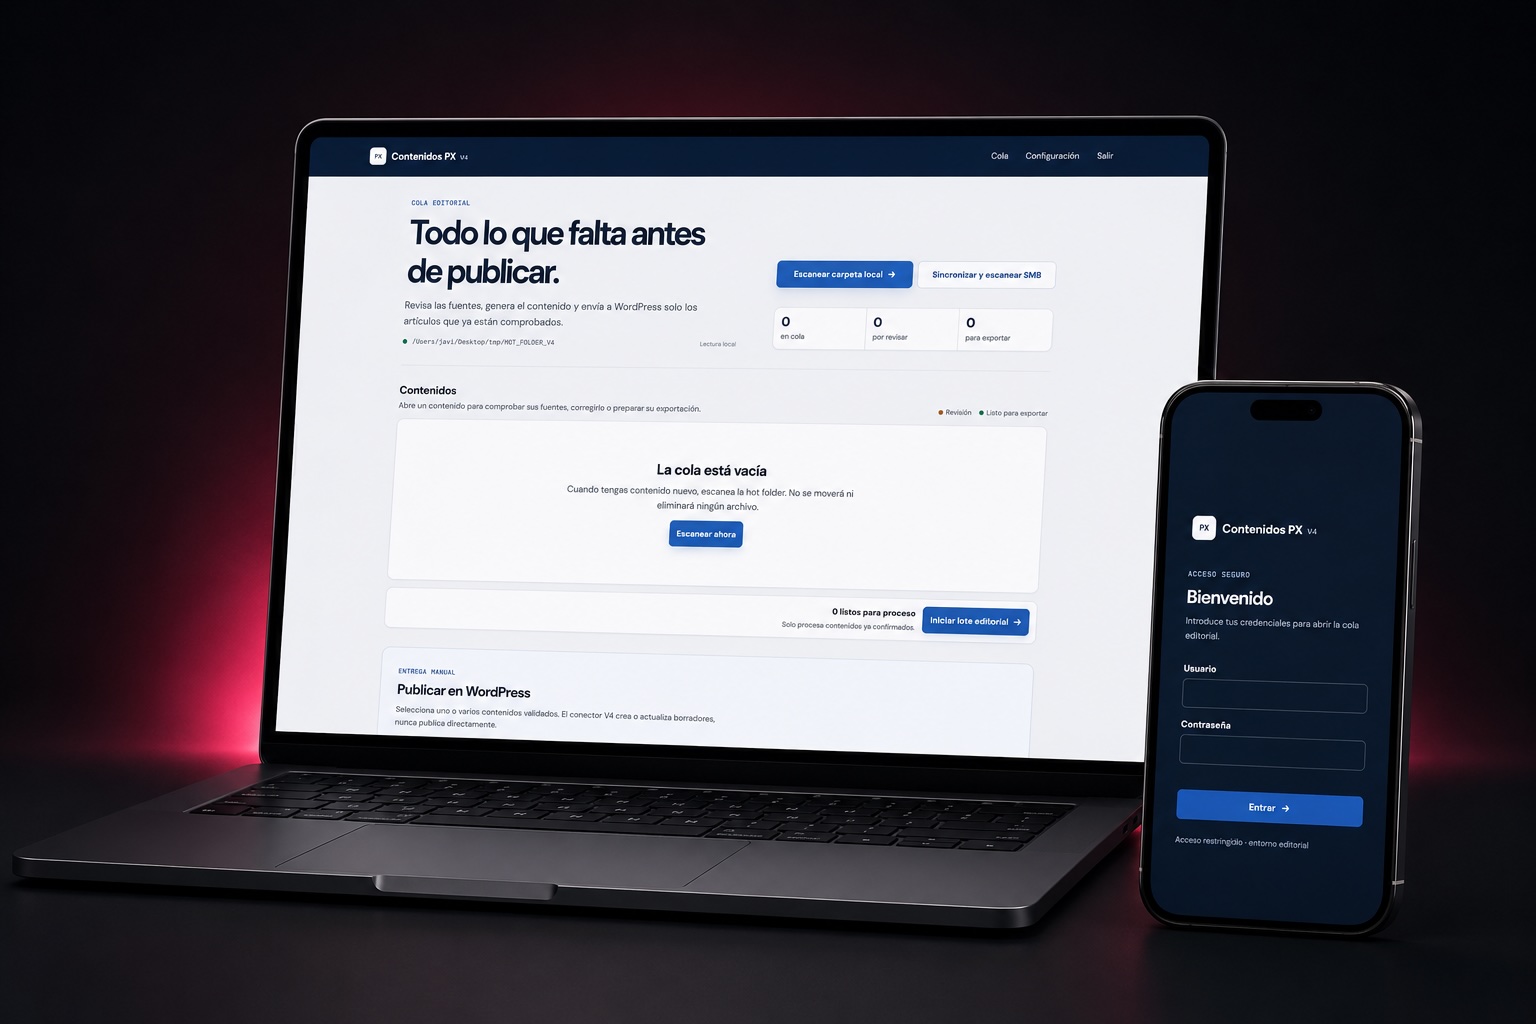
Els materials arriben des de la carpeta compartida. L’aplicació els importa sense modificar els originals, extreu la informació, proposa una classificació i prepara un esborrany editorial.
Abans d’enviar-lo a WordPress, l’editor pot revisar les fonts, confirmar les dades importants i corregir el text. La validació comprova que no faltin dades necessàries i que la informació principal coincideixi amb els documents originals.
D’aquesta manera, l’equip redueix el temps dedicat a les tasques repetitives, però manté el control sobre el contingut final.
El sistema també permet treballar amb lots, reintentar només els elements que fallen i recuperar processos interromputs. Quan el contingut és vàlid, es prepara l’enviament a WordPress com a esborrany, amb la categoria, el municipi, les imatges i les metadades corresponents.
El resultat és una base funcional i estable que ja resol el flux principal i que es pot ampliar amb noves categories, models i integracions.
Aprenentatges
El desenvolupament del projecte ha consistit a trobar l’equilibri entre automatització i control editorial.
No totes les parts del procés s’han d’automatitzar de la mateixa manera. La lectura, la classificació inicial, la redacció i la preparació d’imatges es poden agilitzar. En canvi, les dates, els preus, els municipis i altres dades importants necessiten una comprovació més estricta.
Per aquest motiu, l’aplicació separa les diferents fases del procés. Primer importa els materials. Després els analitza. A continuació genera el contingut i, abans d’enviar-lo a WordPress, el valida.
Les agendes han estat el millor exemple d’aquesta necessitat. La IA pot ajudar a ordenar i redactar un programa, però les dates es tracten com a dades estructurades i es calculen amb regles pròpies.
També s’ha separat la configuració editorial del codi. Els models, els prompts, les estructures, les regles SEO i les plantilles es poden modificar sense haver de canviar l’aplicació.
El resultat és una eina que automatitza una part important del treball, però que manté visibles les fonts, les excepcions i les decisions que encara corresponen a l’editor.