Contenidos e IA
Automatización editorial para Pànxing.net
Una aplicación que transforma documentos, carteles, programas y otros materiales editoriales en borradores preparados para revisar y enviar a WordPress, manteniendo el control sobre las fuentes y los datos importantes.
- Estado
- En producción controlada
- Rol
- Desarrollador principal
Problema
Crear contenidos para un portal editorial implica mucho más que redactar un texto. Cada material que llega al equipo puede tener un formato diferente y contener solo una parte de la información necesaria. Un documento puede incluir una descripción completa, mientras que un cartel puede mostrar únicamente el título de una actividad, una fecha y una hora. A partir de este material hay que preparar un contenido con una categoría, un municipio, una estructura editorial, información SEO y las imágenes correspondientes. También hay que asegurarse de que los datos publicados coinciden con la fuente original. Este último punto es especialmente importante en las agendas. Si el sistema inventa un año, añade un lugar que no aparece en el cartel o completa una actividad que no estaba indicada, el resultado puede parecer correcto pero contener información falsa. El reto era automatizar parte del proceso sin perder la precisión editorial ni obligar al editor a revisarlo todo desde el principio.
Contexto
Pànxing.net es un sitio web que recopila la información publicada en las revistas impresas de los cabeceros Pànxing Cerdanya, Pànxing Maresme y Pànxing Berguedà.
Para elaborar estas revistas, el equipo recibe materiales muy diversos: documentos Word, PDFs, textos, carteles, programas de actividades y fotografías.
Estos materiales deben acabar convertidos en contenidos para la web y, posteriormente, en entradas de WordPress según la categoría y el municipio correspondientes.
El proyecto se creó para ayudar en este proceso: leer los materiales, preparar una primera propuesta editorial y dejar que el editor se concentrara en confirmar datos, resolver dudas y aprobar el resultado.
Evolución del proyecto
El proyecto comenzó con una idea general: crear una herramienta que ayudara a transformar materiales editoriales en contenidos para Pànxing.net.
La primera versión sirvió para validar el concepto. Se probó si era posible extraer información, clasificar los materiales y generar textos con IA.
A medida que se probaron casos reales, aparecieron nuevos problemas: documentos incompletos, carteles difíciles de leer, clasificaciones incorrectas, fechas con formatos distintos y contenidos que necesitaban tratamientos editoriales diferentes.
Las versiones siguientes fueron incorporando el flujo completo: importación de materiales, clasificación, generación de contenidos y exportación a WordPress.
Una de las versiones intermedias, que internamente se consideró una V2 pero que en realidad correspondería a una tercera etapa, añadió gran parte de la base actual del proyecto.
A partir de esta base se incorporaron:
- revisión de fuentes;
- hechos detectados y evidencias;
- perfiles editoriales;
- reglas SEO;
- estructuras por categoría;
- preparación de imágenes;
- corrección manual;
- validación antes de la exportación;
- sincronización SMB;
- procesamiento persistente de lotes;
- reintentos selectivos;
- envío idempotente a WordPress.
La versión actual es el resultado de este proceso. Ya no es solo un prototipo para comprobar si la idea funcionaba, sino un MVP funcional que resuelve el flujo principal y permite continuar escalándolo.
Funcionamiento
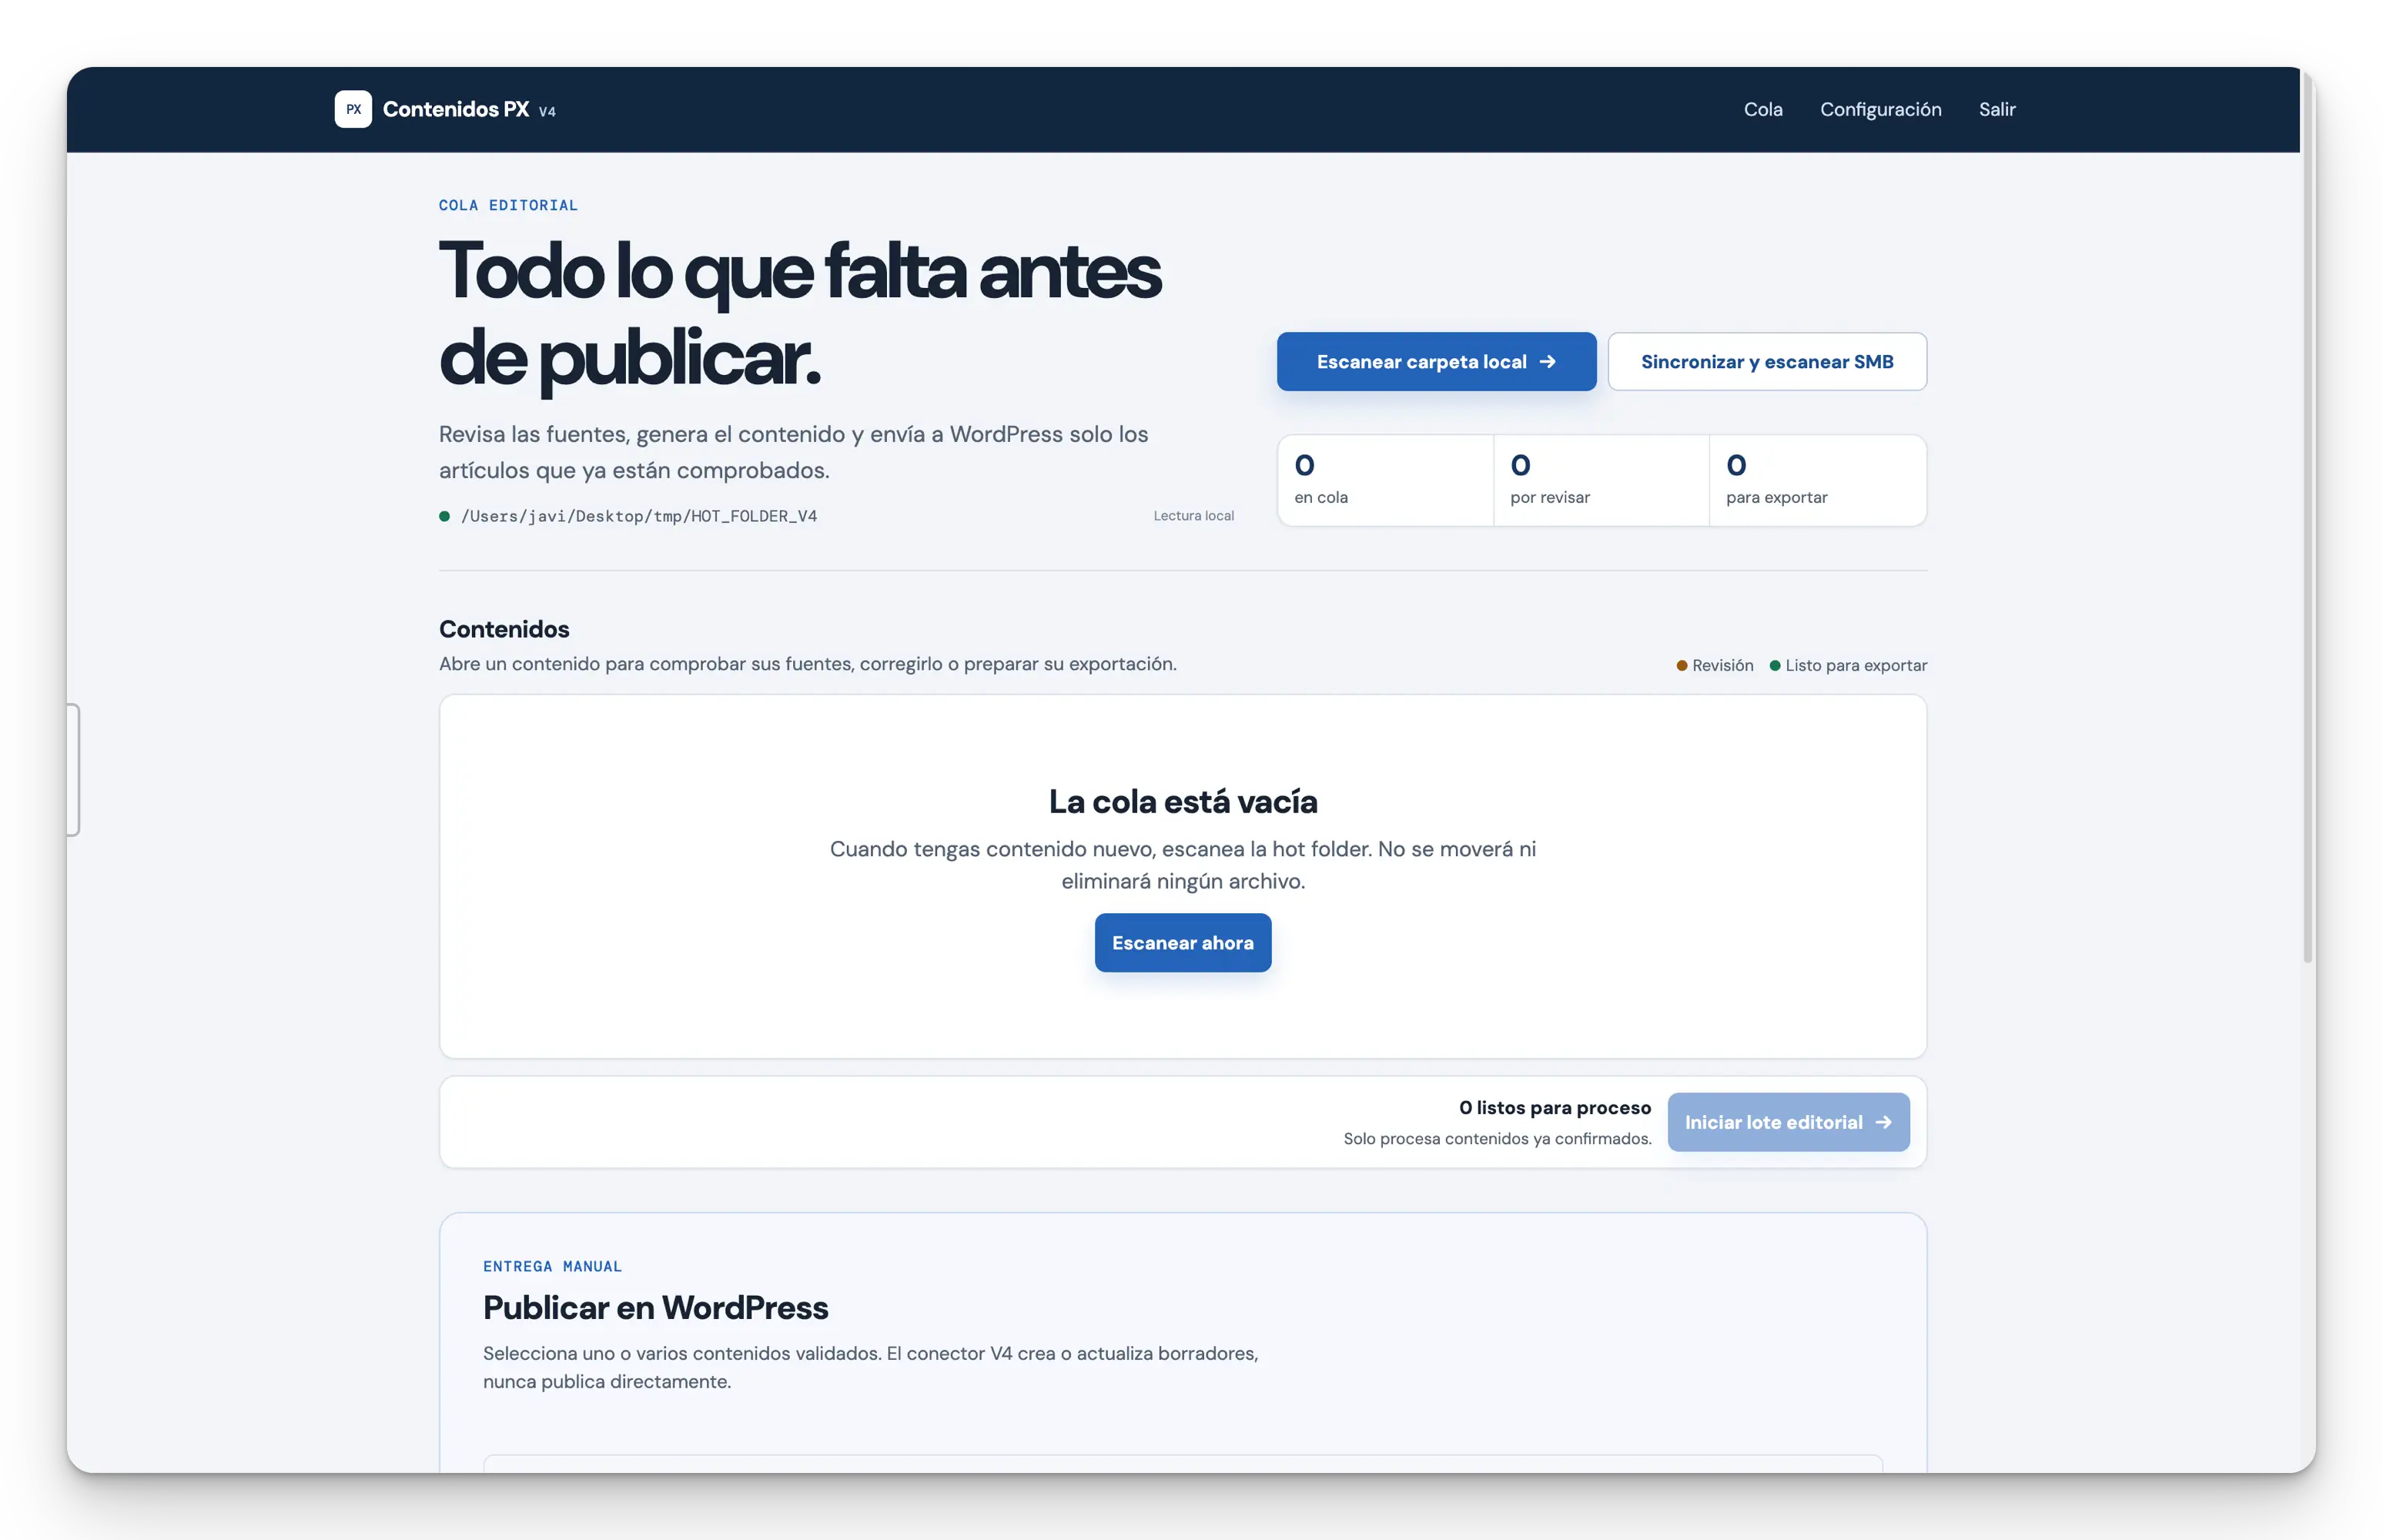
1. Sincronización con SMB
El editor inicia manualmente la sincronización con la carpeta compartida SMB.
La aplicación recorre los archivos compatibles, los copia a su propio espacio de trabajo y calcula una huella SHA-256 para evitar duplicados.
Los archivos originales no se mueven, no se cambian de nombre y no se eliminan.
La sincronización funciona como un trabajo independiente. La interfaz muestra el progreso de la copia y permite ver qué elementos se han importado, cuáles ya existían y cuáles han fallado.
2. Análisis de las fuentes
Cuando la copia ha terminado, comienza una segunda fase de análisis.
El sistema extrae texto de archivos DOCX, PDF, TXT y Markdown. En el caso de las imágenes, puede utilizar OCR local, transcripción visual con IA o ambas opciones.
Los resultados se conservan por separado. Esto permite comprobar qué ha leído el OCR, qué ha interpretado el modelo visual y qué información proviene directamente del documento.
Si un contenido falla, el problema queda asociado solo a ese elemento. El resto del lote puede continuar y el elemento fallido se puede reintentar más adelante.
3. Clasificación
La clasificación inicial utiliza la carpeta y el nombre de los archivos. Después, la aplicación puede analizar el contenido para confirmar o proponer otra categoría y municipio.
Las opciones disponibles provienen de un catálogo configurado. Si la clasificación inicial y la analizada no coinciden, el sistema muestra la diferencia y pide que el editor la confirme.
La categoría determina el tratamiento editorial y también el tipo de contenido que se enviará a WordPress.
4. Revisión de fuentes
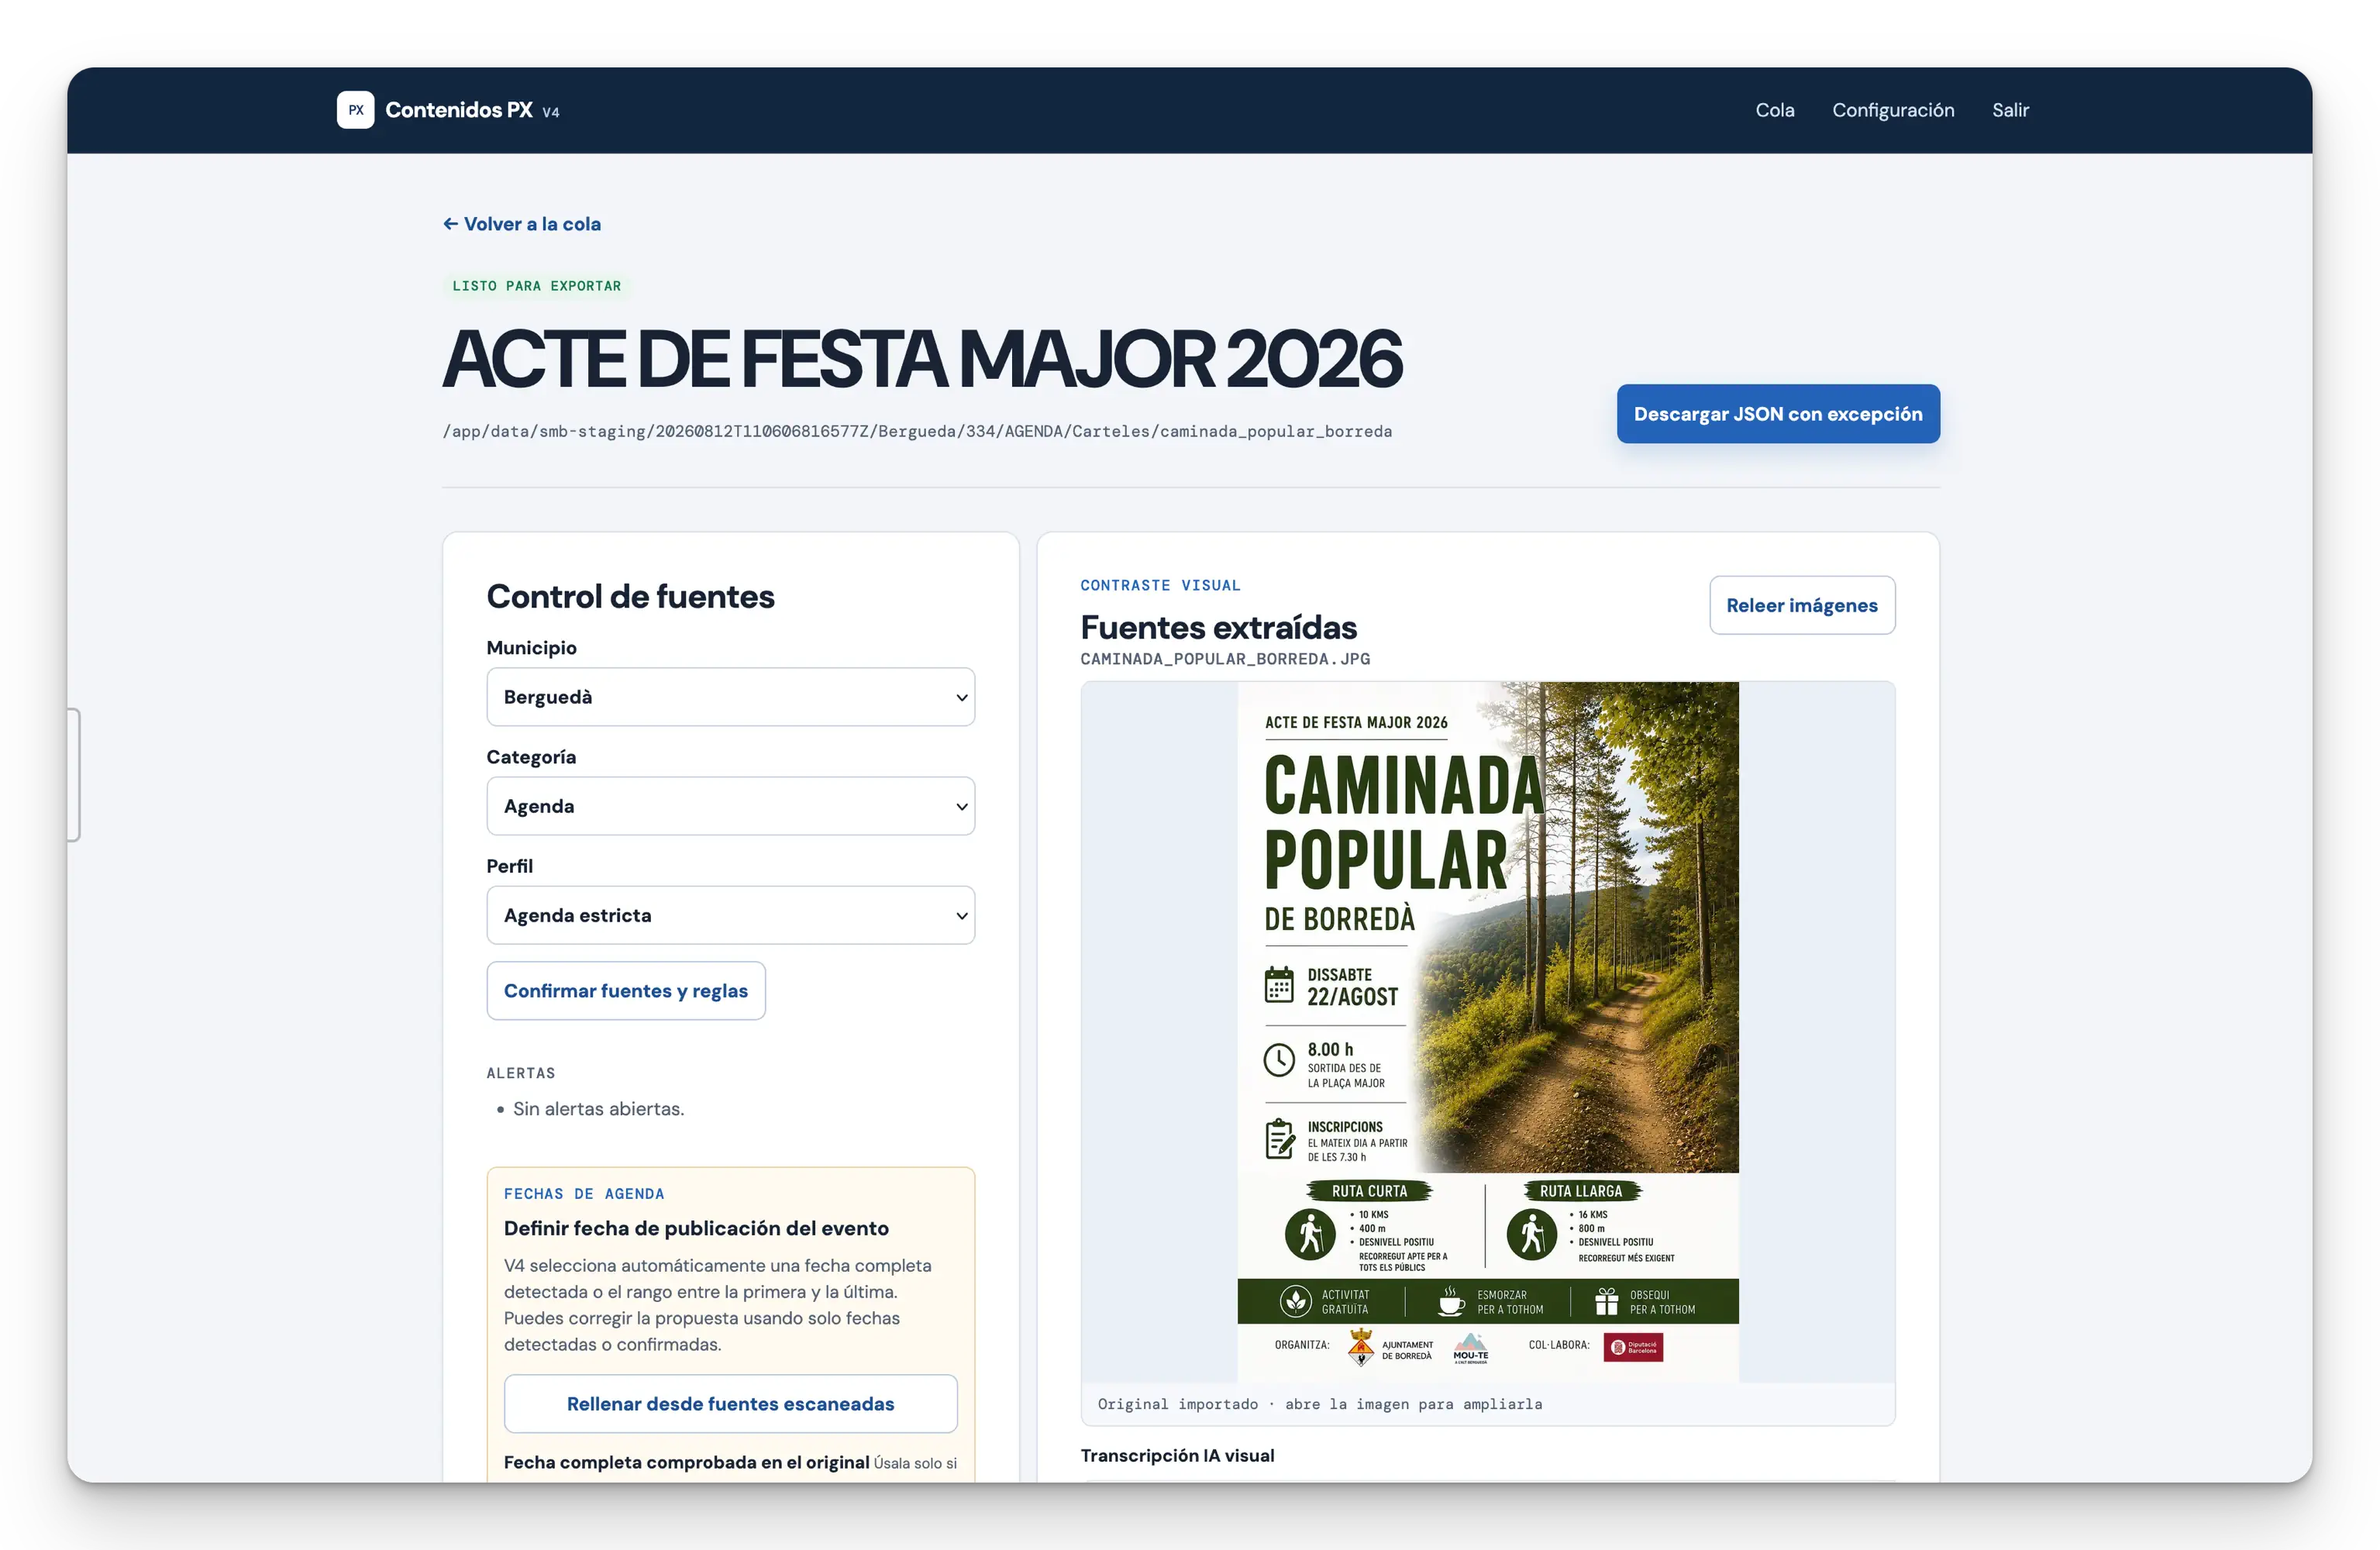
Antes de generar el artículo, el editor puede abrir la ficha del contenido.
En esta ficha puede consultar los archivos originales, el texto extraído, la transcripción visual, las imágenes y los hechos detectados.
También puede añadir datos confirmados o instrucciones editoriales. Por ejemplo, puede confirmar una fecha completa que no se lee bien en el cartel o indicar que una entrevista se debe conservar con su formato de preguntas y respuestas.
Este paso permite resolver las dudas antes de redactar y evita que la IA intente completar automáticamente las partes que faltan.
5. Generación del contenido
Cuando las fuentes ya se han revisado, se genera el borrador editorial.
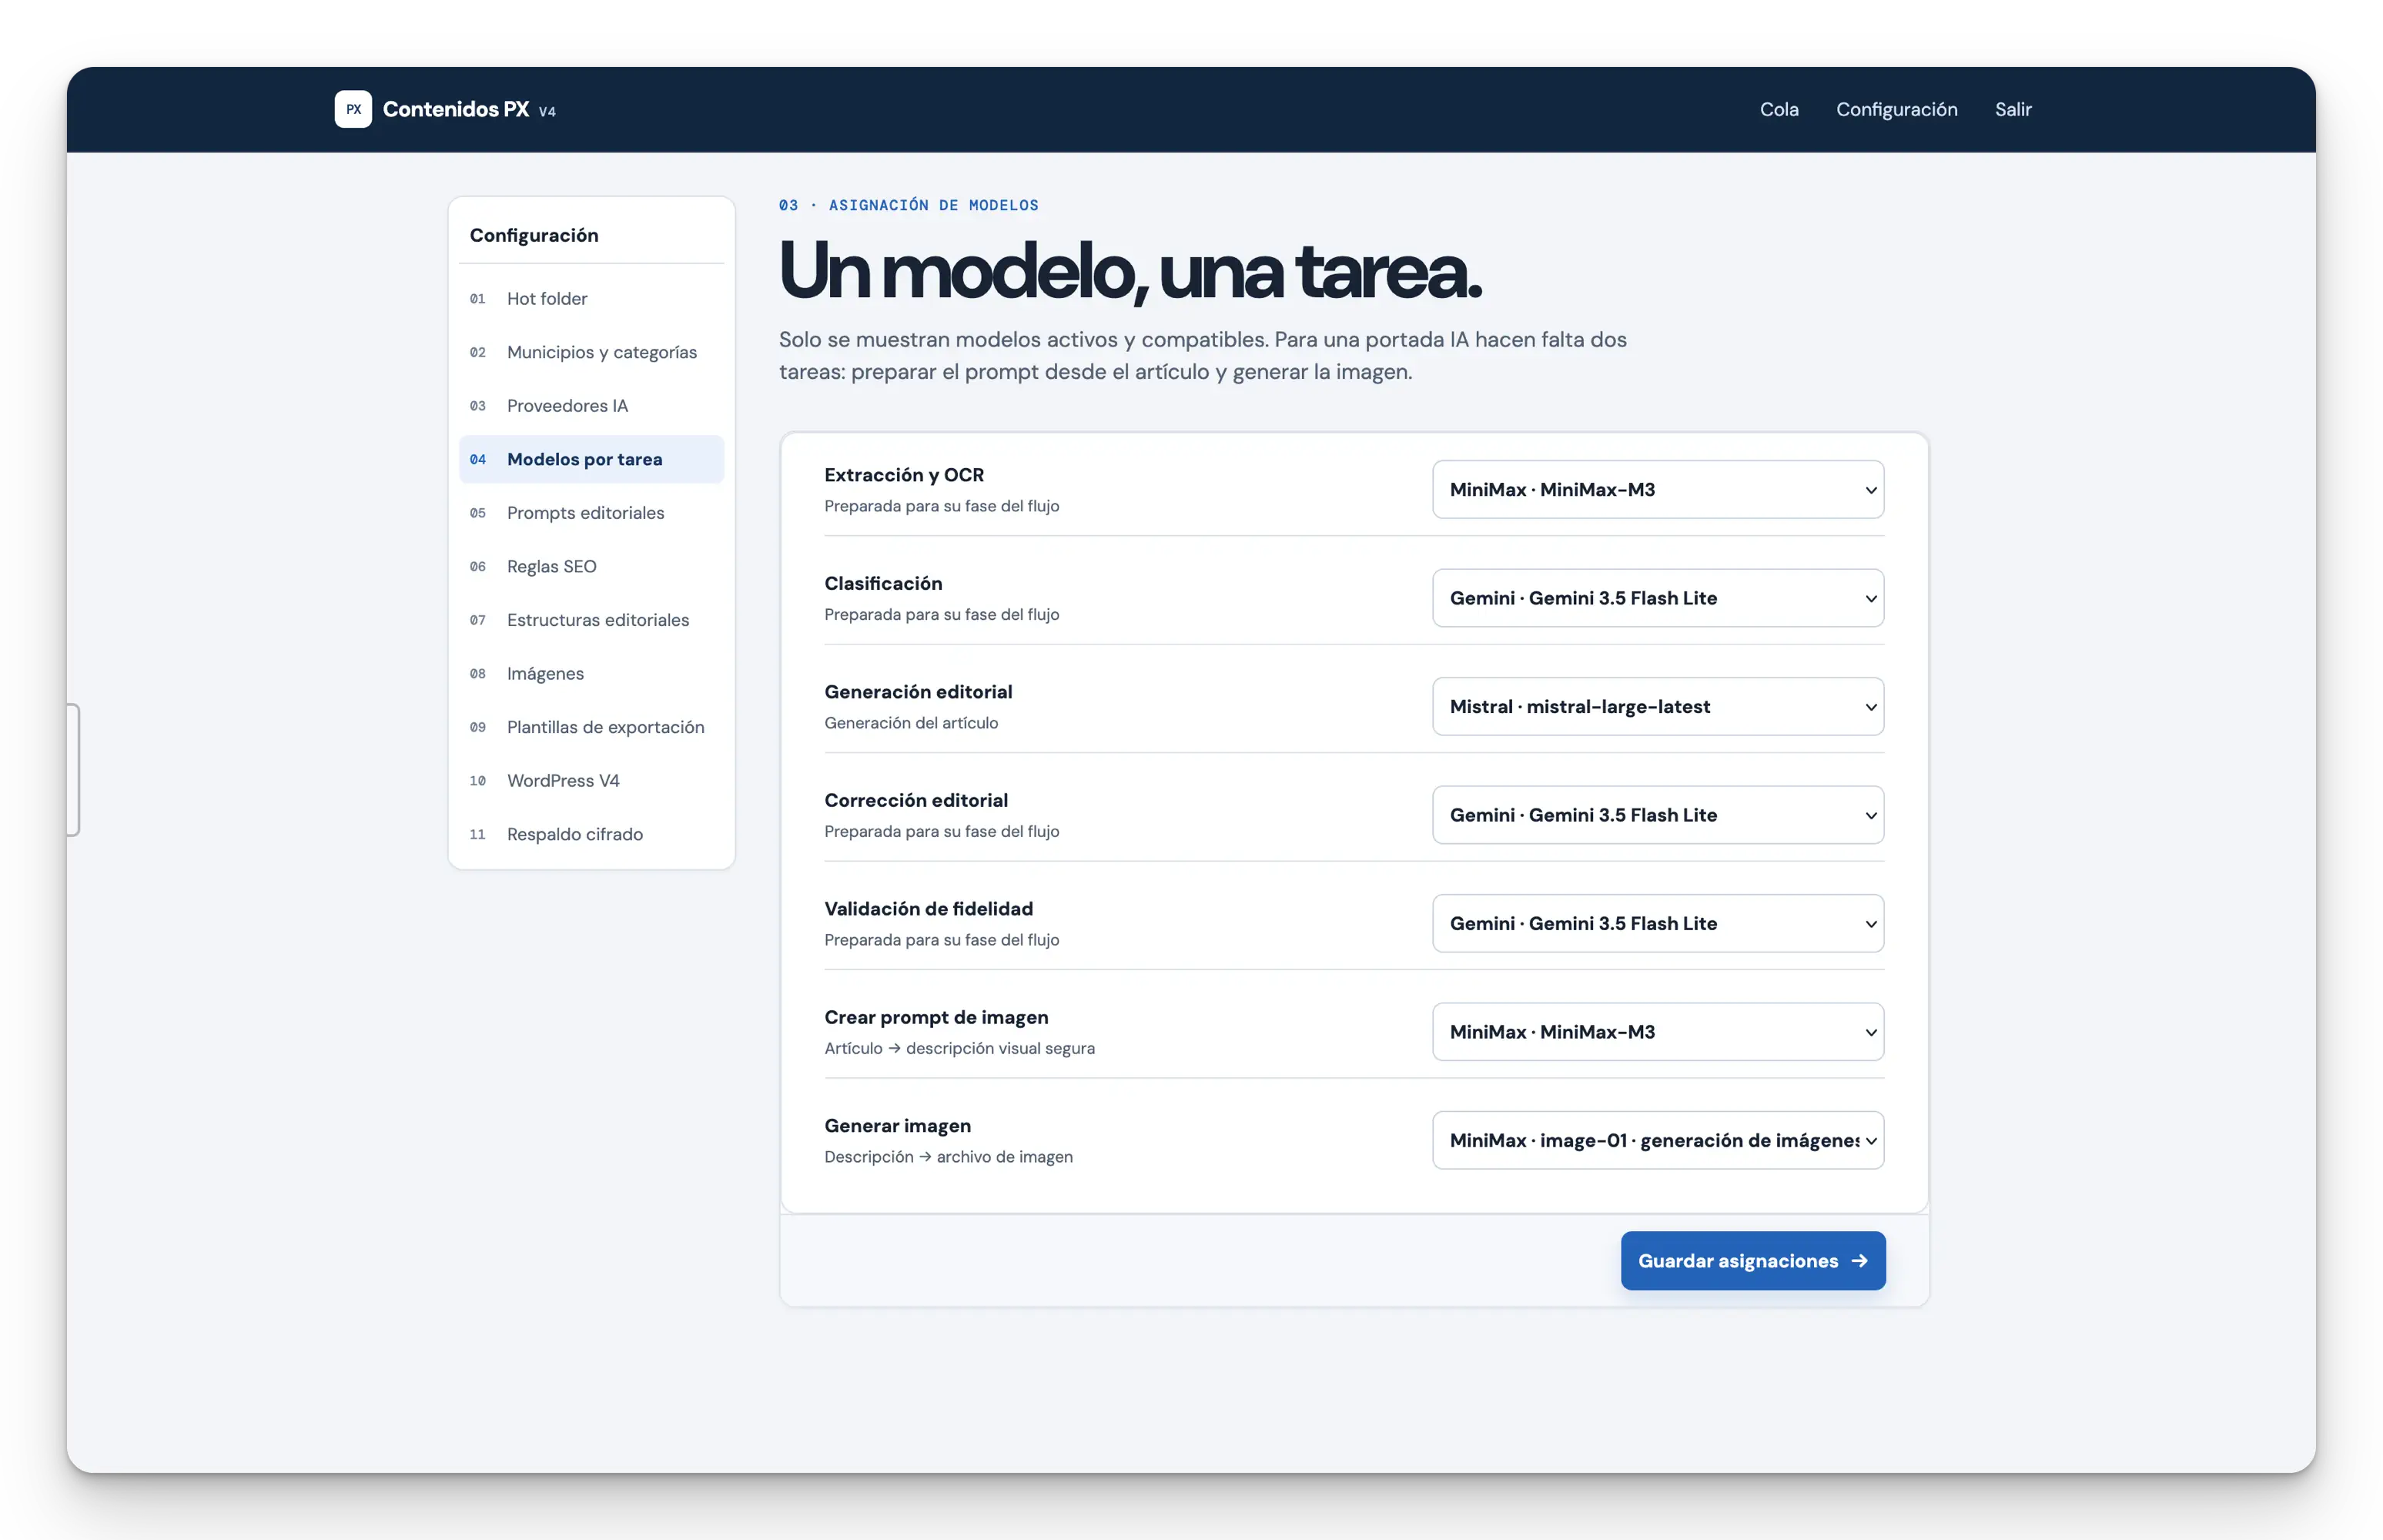
La configuración permite asignar diferentes proveedores y modelos según la tarea: clasificación, transcripción visual, generación, corrección, validación o generación de imágenes.
Los perfiles editoriales principales son:
- Agenda estricta: conserva el programa y solo utiliza datos confirmados.
- Entrevista literal: mantiene las preguntas, las respuestas y el orden original.
- Cliente fiel: corrige el texto con una intervención mínima.
- Editorial controlado: mejora la estructura sin añadir información nueva.
La IA ayuda a ordenar y redactar el contenido, pero no puede completar los datos que faltan.
6. Tratamiento de las agendas
Las agendas han sido una de las partes más difíciles del proyecto.
Un programa puede tener diversas actividades, días distintos, horas, precios y ubicaciones. Además, la información puede aparecer en formatos diferentes o estar repartida entre varias páginas e imágenes.
Las fechas no las decide la IA. La aplicación las normaliza con código y diferencia entre eventos de un solo día, listas de días y periodos con fecha de inicio y de final.
Si una fecha no está completa o no se puede verificar, la agenda queda bloqueada hasta que el editor la confirme.
Esto evita que el sistema deduzca el año, invente una fecha final o transforme una información parcial en un evento incorrecto.
7. Imágenes
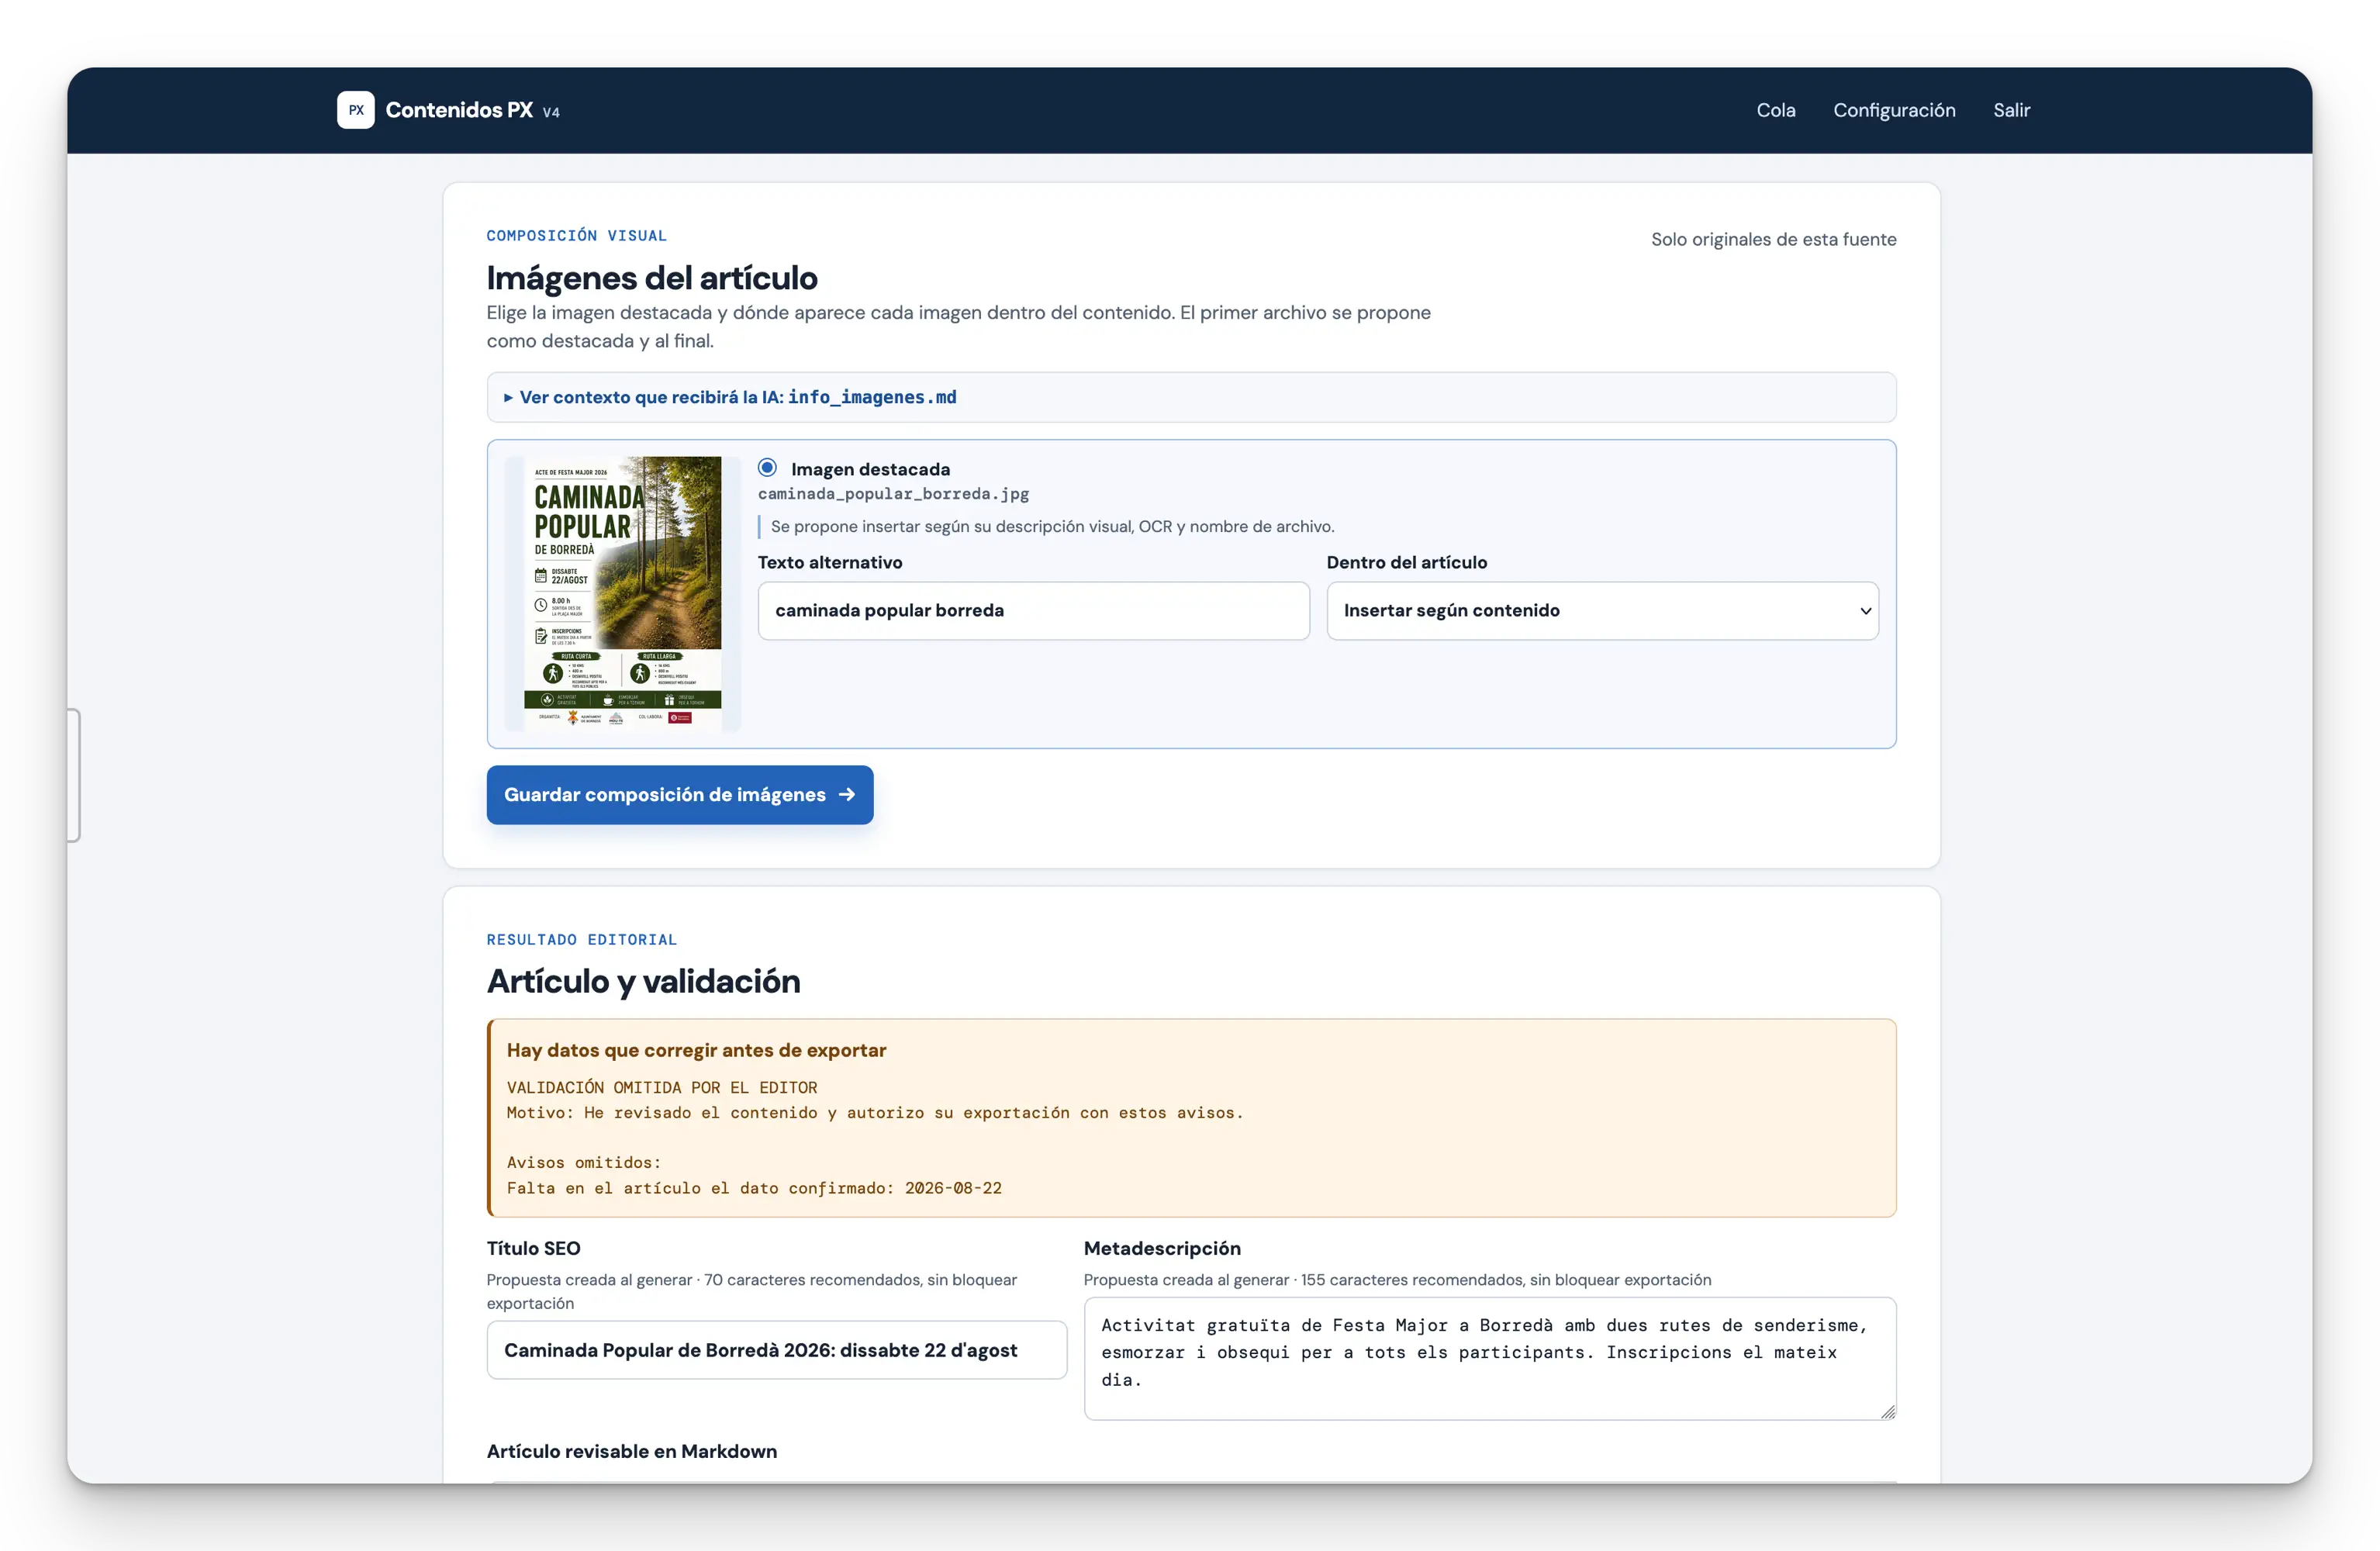
Las imágenes importadas se conservan junto con el contenido al que pertenecen.
La aplicación puede crear versiones optimizadas para la web sin modificar el original. El editor puede seleccionar la imagen destacada, añadir el texto alternativo y decidir qué imágenes aparecen dentro del artículo.
Cuando no hay ninguna imagen disponible, se puede generar una portada con MiniMax. Esta imagen queda identificada como generada por IA y no se considera una fuente informativa.
8. Validación
Antes de exportar, el contenido pasa por una validación automática.
La validación comprueba fechas, horas, precios, municipios, categorías, metadatos y hechos principales. También detecta información crítica ausente, contradicciones y datos que no están justificados por las fuentes.
Los resultados se dividen en:
- Correcto: el contenido se puede exportar.
- Aviso: hay una mejora posible, pero no bloquea el proceso.
- Error: es necesario corregir o confirmar la información antes de continuar.
El editor puede modificar el Markdown desde la misma ficha y volver a validar.
9. Envío a WordPress
Cuando el contenido es válido, se crea un trabajo de envío a WordPress.
El sistema prepara el payload según la categoría, asigna el CPT correspondiente, vincula el municipio y añade las taxonomías y metadatos necesarios.
También envía solo las imágenes seleccionadas y utiliza un identificador estable para evitar duplicados en caso de reintento.
WordPress recibe siempre un borrador. La publicación definitiva sigue dependiendo de la revisión editorial.
Dificultades
Comenzar con una idea y convertirla en un producto funcional
El proyecto no comenzó con una especificación cerrada. Al principio solo estaba clara la finalidad general: ayudar a preparar los contenidos de Pànxing.net.
El proceso consistió en crear prototipos, probarlos con materiales reales, comprobar qué funcionaba y detectar qué partes no aportaban suficiente valor.
Algunas ideas parecían buenas inicialmente, pero complicaban el flujo o no eran lo suficientemente fiables. Esto obligó a simplificar, separar fases, priorizar las funciones importantes y convertir el prototipo inicial en un MVP funcional.
Generar contenidos sin crear información falsa
La generación con IA era útil, pero también era la parte con más riesgo.
El sistema debía poder transformar un texto breve o un cartel en un artículo legible sin añadir datos que no aparecieran en la fuente.
Para lograrlo, se combinaron prompts, perfiles editoriales, hechos detectados, instrucciones del editor y validaciones independientes.
La generación debía servir para redactar mejor, no para rellenar los huecos con información inventada.
Crear agendas fiables
Las agendas concentraron gran parte de la complejidad del proyecto.
No bastaba con extraer el texto de un cartel. Era necesario conservar todas las actividades, interpretar correctamente las fechas, diferenciar rangos, detectar información incompleta y preparar los datos que necesita WordPress.
La solución final separa la redacción de la gestión de fechas. La IA puede ayudar a redactar el contenido, pero las fechas se calculan y validan de manera determinista.
Leer carteles y documentos visuales
Los carteles pueden tener columnas, tipografías decorativas, fondos complejos o información muy condensada.
El OCR local es útil, pero no siempre interpreta bien la distribución visual. La transcripción con IA puede aportar una lectura mejor, pero también debe revisarse.
Por eso la aplicación conserva los resultados de ambas vías y los muestra al editor antes de generar el artículo.
Procesar lotes con errores parciales
Una sincronización puede contener muchos archivos y no todos fallan por el mismo motivo.
La solución fue crear trabajos persistentes con progreso por elemento, reintentos selectivos y recuperación tras un reinicio.
Así, un error de conexión, de OCR o de WordPress no obliga a comenzar todo el proceso de nuevo. Solo es necesario reintentar los elementos que no han completado su fase.
Resultado
El proyecto ha convertido un proceso editorial manual en un flujo de trabajo más ordenado y controlado.
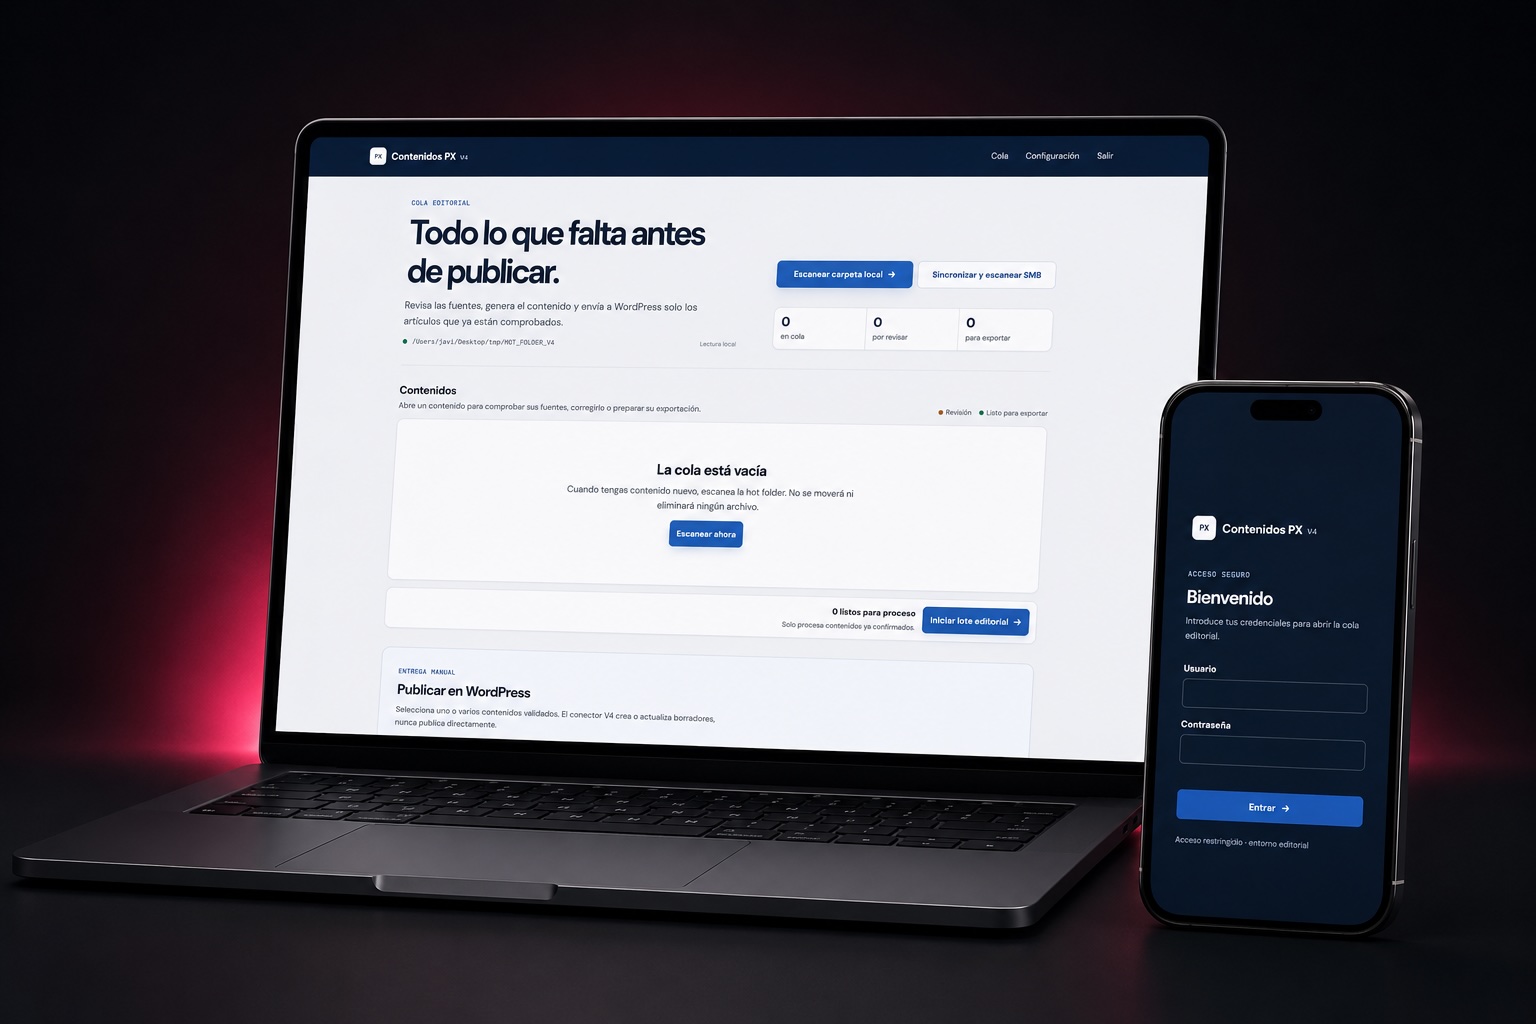
Los materiales llegan desde la carpeta compartida. La aplicación los importa sin modificar los originales, extrae la información, propone una clasificación y prepara un borrador editorial.
Antes de enviarlo a WordPress, el editor puede revisar las fuentes, confirmar los datos importantes y corregir el texto. La validación comprueba que no falten datos necesarios y que la información principal coincida con los documentos originales.
De esta manera, el equipo reduce el tiempo dedicado a las tareas repetitivas, pero mantiene el control sobre el contenido final.
El sistema también permite trabajar con lotes, reintentar solo los elementos que fallan y recuperar procesos interrumpidos. Cuando el contenido es válido, se prepara el envío a WordPress como borrador, con la categoría, el municipio, las imágenes y los metadatos correspondientes.
El resultado es una base funcional y estable que ya resuelve el flujo principal y que se puede ampliar con nuevas categorías, modelos e integraciones.
Aprendizajes
El desarrollo del proyecto ha consistido en encontrar el equilibrio entre automatización y control editorial.
No todas las partes del proceso deben automatizarse de la misma manera. La lectura, la clasificación inicial, la redacción y la preparación de imágenes se pueden agilizar. En cambio, las fechas, los precios, los municipios y otros datos importantes necesitan una comprobación más estricta.
Por este motivo, la aplicación separa las diferentes fases del proceso. Primero importa los materiales. Después los analiza. A continuación genera el contenido y, antes de enviarlo a WordPress, lo valida.
Las agendas han sido el mejor ejemplo de esta necesidad. La IA puede ayudar a ordenar y redactar un programa, pero las fechas se tratan como datos estructurados y se calculan con reglas propias.
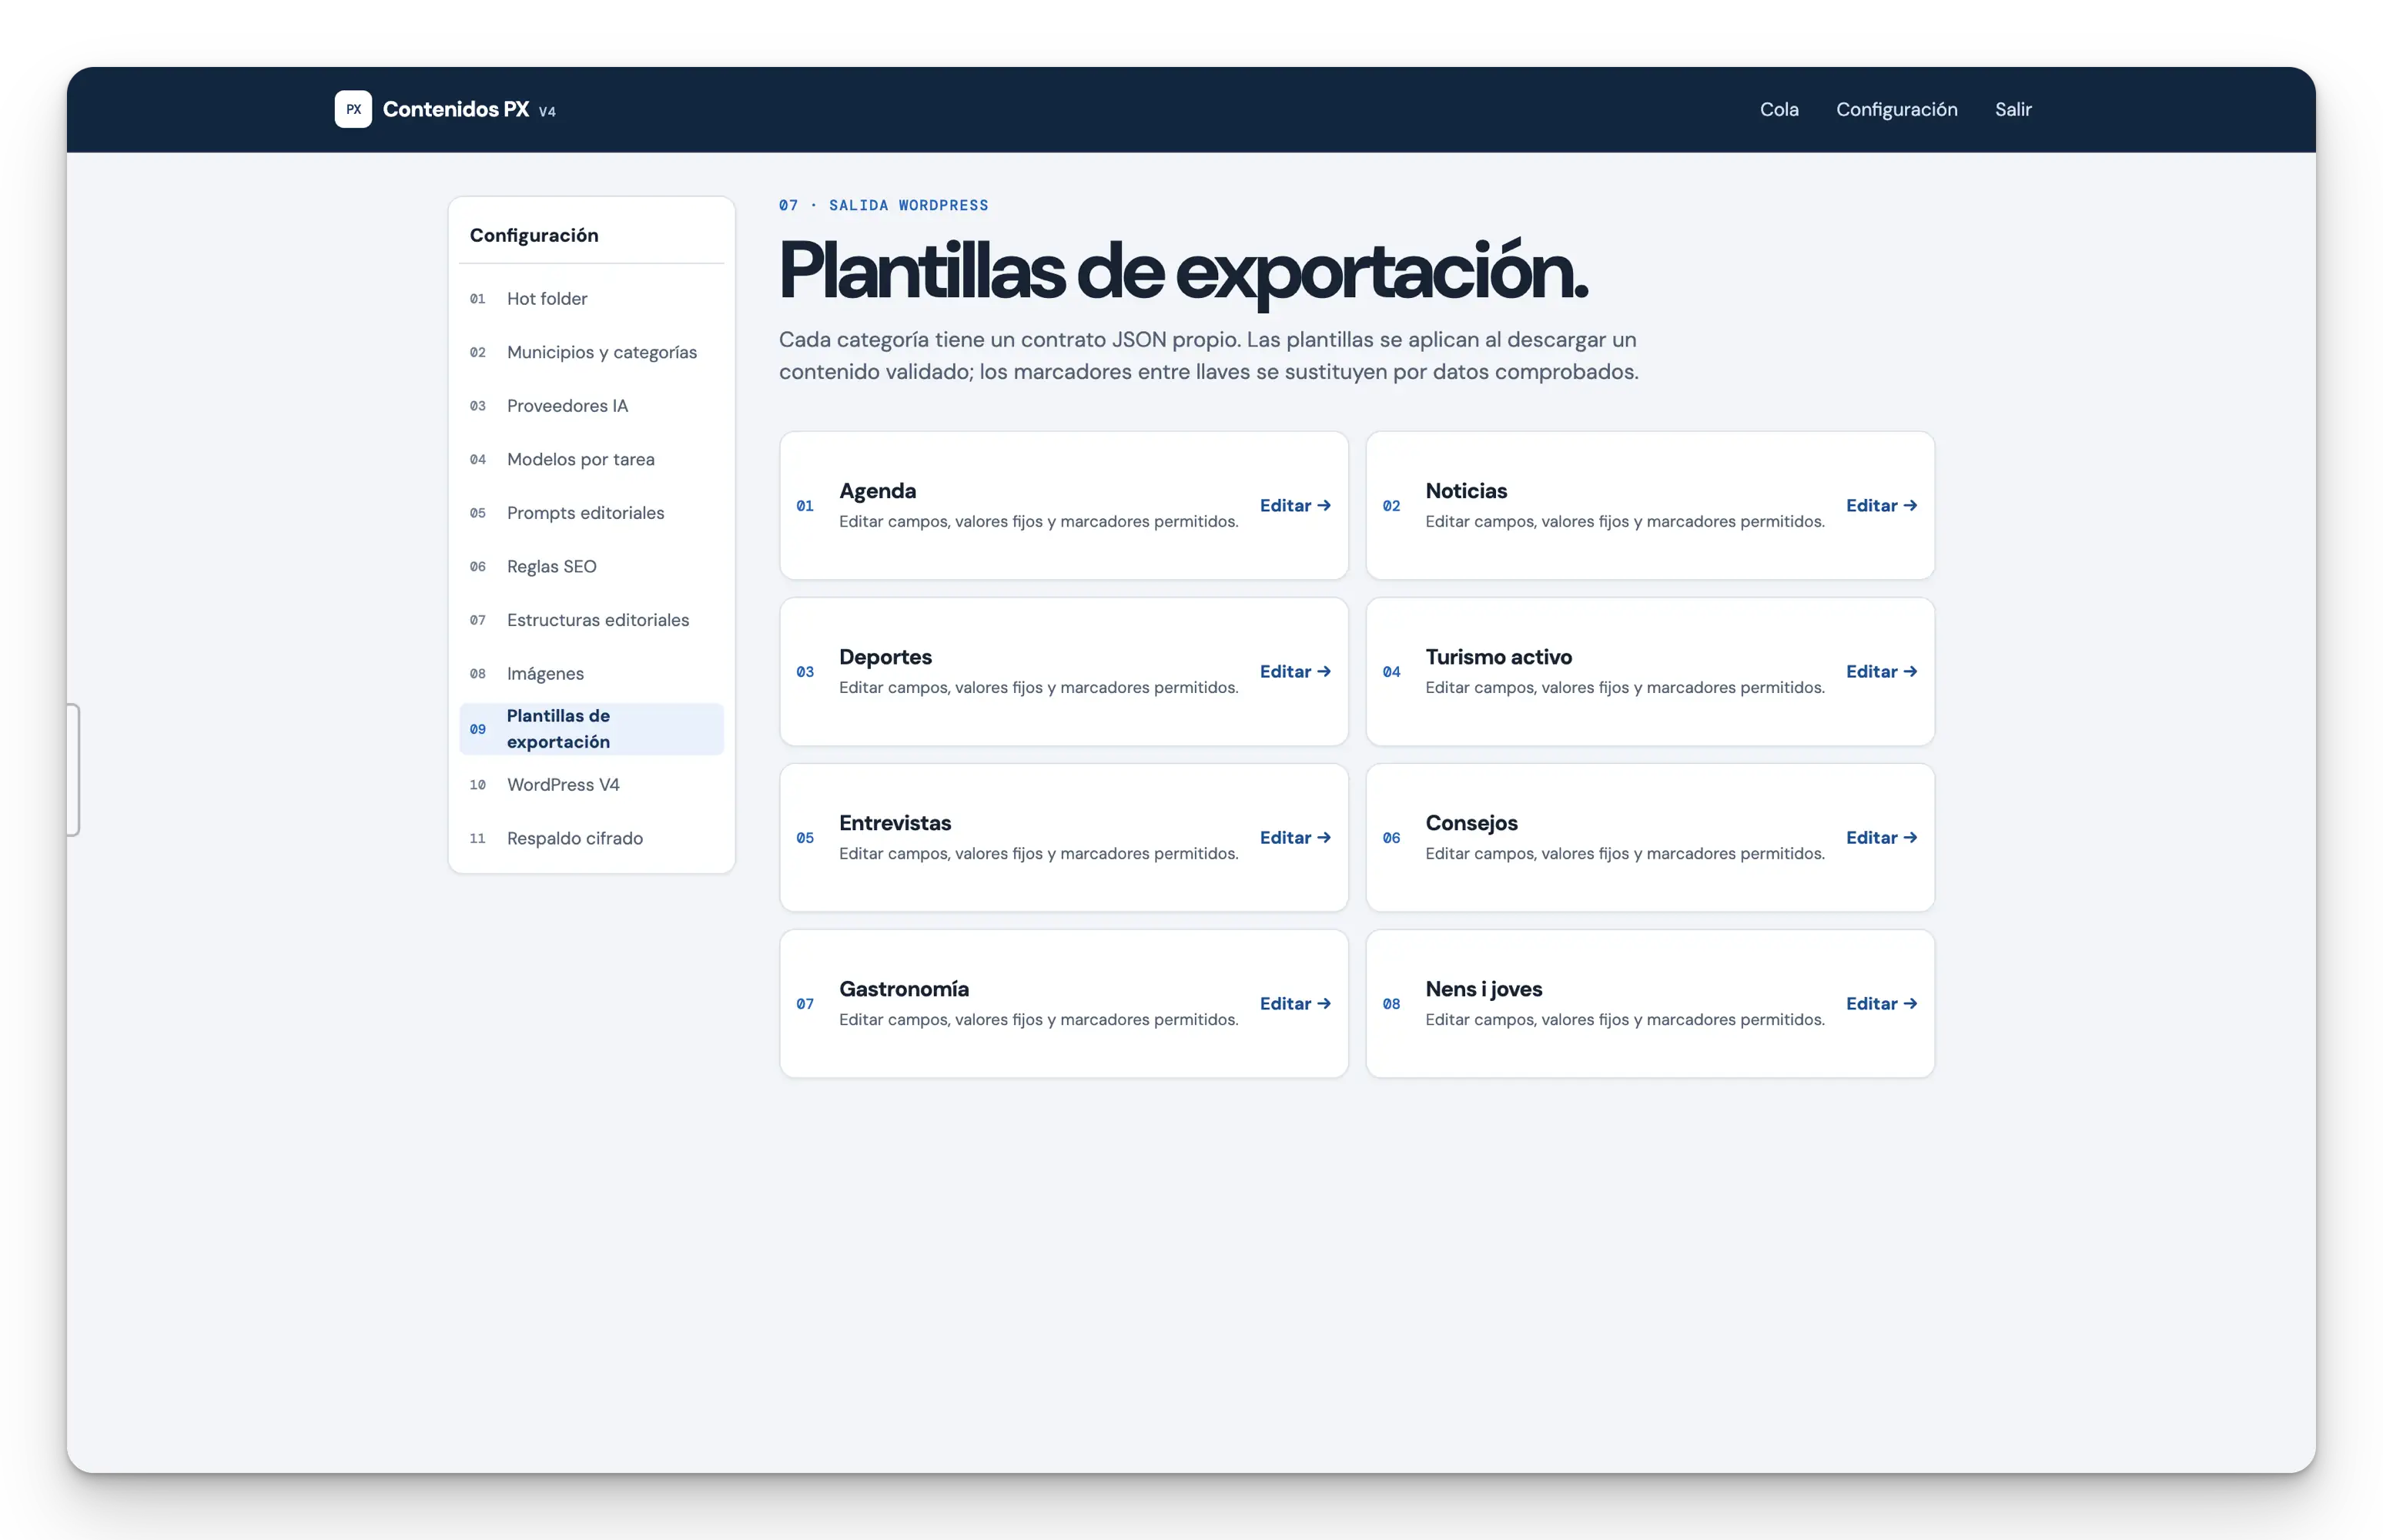
También se ha separado la configuración editorial del código. Los modelos, los prompts, las estructuras, las reglas SEO y las plantillas se pueden modificar sin tener que cambiar la aplicación.
El resultado es una herramienta que automatiza una parte importante del trabajo, pero que mantiene visibles las fuentes, las excepciones y las decisiones que aún corresponden al editor.